AudioToText wandelt Audio per Transkription in Text um.
Es ist von der vollständigen Aufnahme von Sprachkanälen getrennt und lässt sich nutzen, wenn dein Server Sprachnachrichten oder Audiodateien in lesbaren Text umwandeln soll.
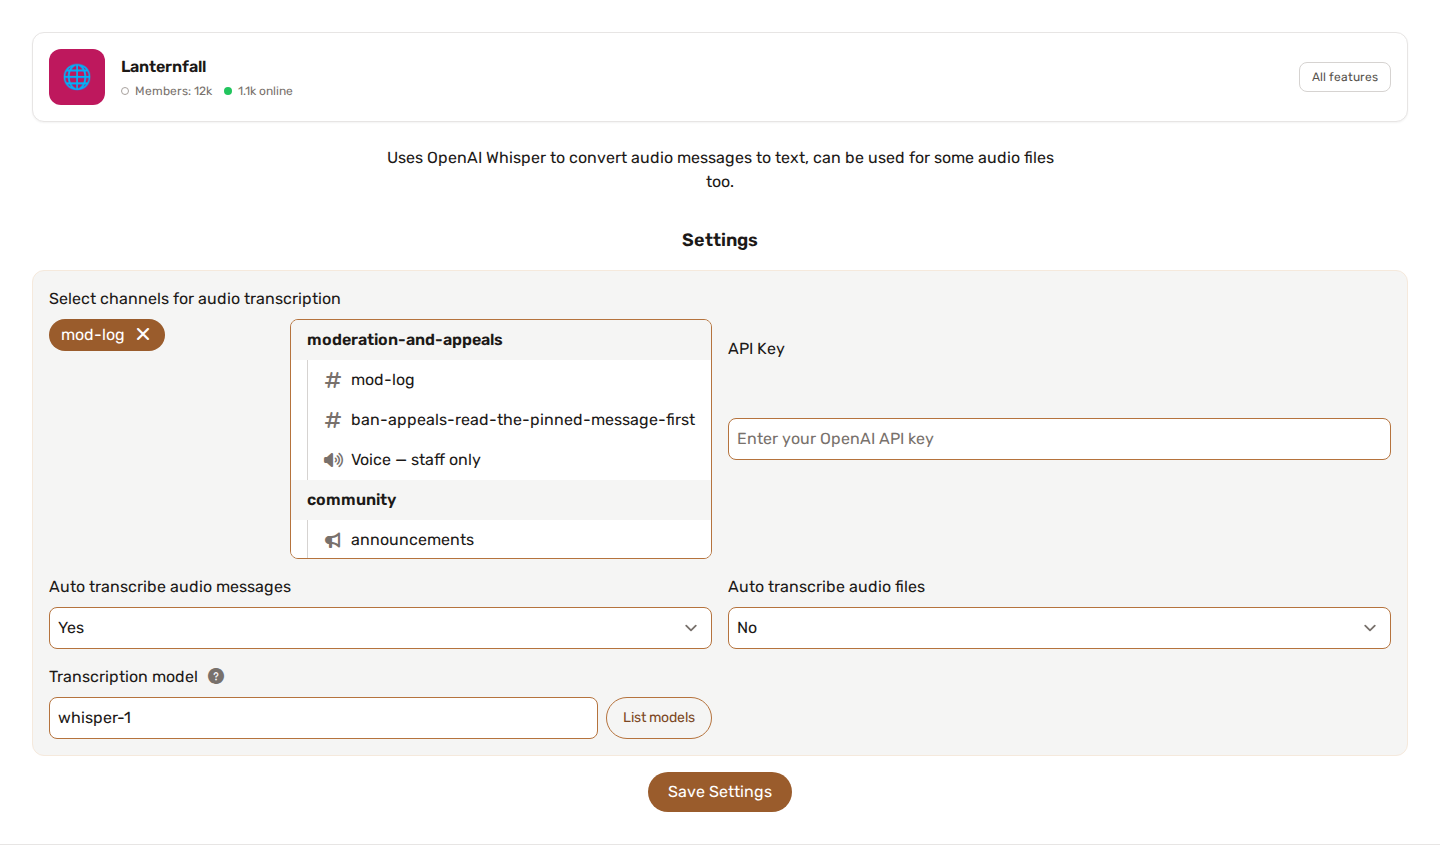
🎙️ Was AudioToText macht
AudioToText nimmt unterstützte Audioeingaben entgegen und erzeugt ein Transkript.
Das kann helfen bei:
- Barrierefreiheit
- Prüfung durch die Moderation
- Meeting-Notizen
- Zusammenfassungen von Sprachnachrichten
- Durchsuchbaren Aufzeichnungen
⚙️ Konfiguration
Je nach Einrichtung deines Servers kann AudioToText Folgendes erfordern:
- Einen Kanal, in dem Audio verarbeitet wird
- Einen API-Schlüssel
- Ein Transkriptionsmodell
- Optional einen eigenen Transkriptions-Endpoint
- Beschränkungen nach Rolle oder Kanal
🔌 Eigener Transkriptions-Endpoint
AudioToText kann einen eigenen, Whisper-kompatiblen Transkriptions-Endpoint nutzen.
Das ist nützlich, wenn du einen eigenen Anbieter oder einen selbst gehosteten Transkriptionsdienst verwenden möchtest.
Mehr dazu findest du unter Custom AI Model Endpoints.
🧠 Das Transkriptionsmodell auswählen
Das Feld Transkriptionsmodell listet die Modelle auf, die dein Endpoint tatsächlich anbietet - das Panel fragt ihn danach, statt eine aus dem Gedächtnis geschriebene Liste zu zeigen - und behält nur die, die transkribieren können.
Lässt du es leer, wird whisper-1 verwendet, was OpenAI bereitstellt. Wenn du AudioToText auf deinen eigenen Server zeigst, ist dieses Feld entscheidend: Eine faster-whisper- oder distil-whisper-Instanz hört selten auf den Namen whisper-1, und die Anfrage nach einem Modell, das sie nicht hat, ist der häufigste Grund dafür, dass ein selbst gehosteter Endpoint nichts zurückgibt.
↔️ Unterschied zur Audio-Aufnahme
AudioToText konzentriert sich auf die Transkription.
Die Audio-Aufnahme konzentriert sich auf das Aufzeichnen von Gesprächen in Sprachkanälen und kann optional Transkription und Zusammenfassungen hinzufügen.
Nutze AudioToText, wenn du hauptsächlich Audio in Text umwandeln willst. Nutze die Audio-Aufnahme, wenn du eine komplette Sprachkanal-Sitzung festhalten willst.
💡 Best Practices
- Teste zuerst mit kurzem Audio.
- Stelle sicher, dass das Dateiformat unterstützt wird.
- Nutze klares Audio für bessere Ergebnisse.
- Vermeide die Transkription sensibler privater Audioaufnahmen, es sei denn, dein Server hat dafür eine klare Richtlinie.
- Prüfe Transkripte, bevor du dich für Moderation oder offizielle Notizen darauf verlässt.