Mit dem AI-Speicher legt YAWBDB nützlichen Kontext für einen Server ab, damit KI-Antworten mit der Zeit konsistenter werden.
Zwei Seiten schreiben hinein: du über das Panel und der Bot, der festhält, was er aus Gesprächen auf Discord lernt. Das Speichersystem wird im Panel verwaltet, und nichts darin wird jemals automatisch entfernt.
🧠 Wofür der Speicher genutzt wird
Der Speicher kann der KI helfen, sich an Informationen wie diese zu erinnern:
- Server-Lore
- Fakten über die Community
- Bevorzugter Tonfall
- Wiederkehrende Insider-Witze
- Kontext zu Mitgliedern oder Rollen
- Serverspezifische Begriffe
- Wichtige Regeln oder Erinnerungen
Ziel ist, dass sich KI-Antworten stärker auf den Server eingestellt anfühlen.
📒 Speicherseite
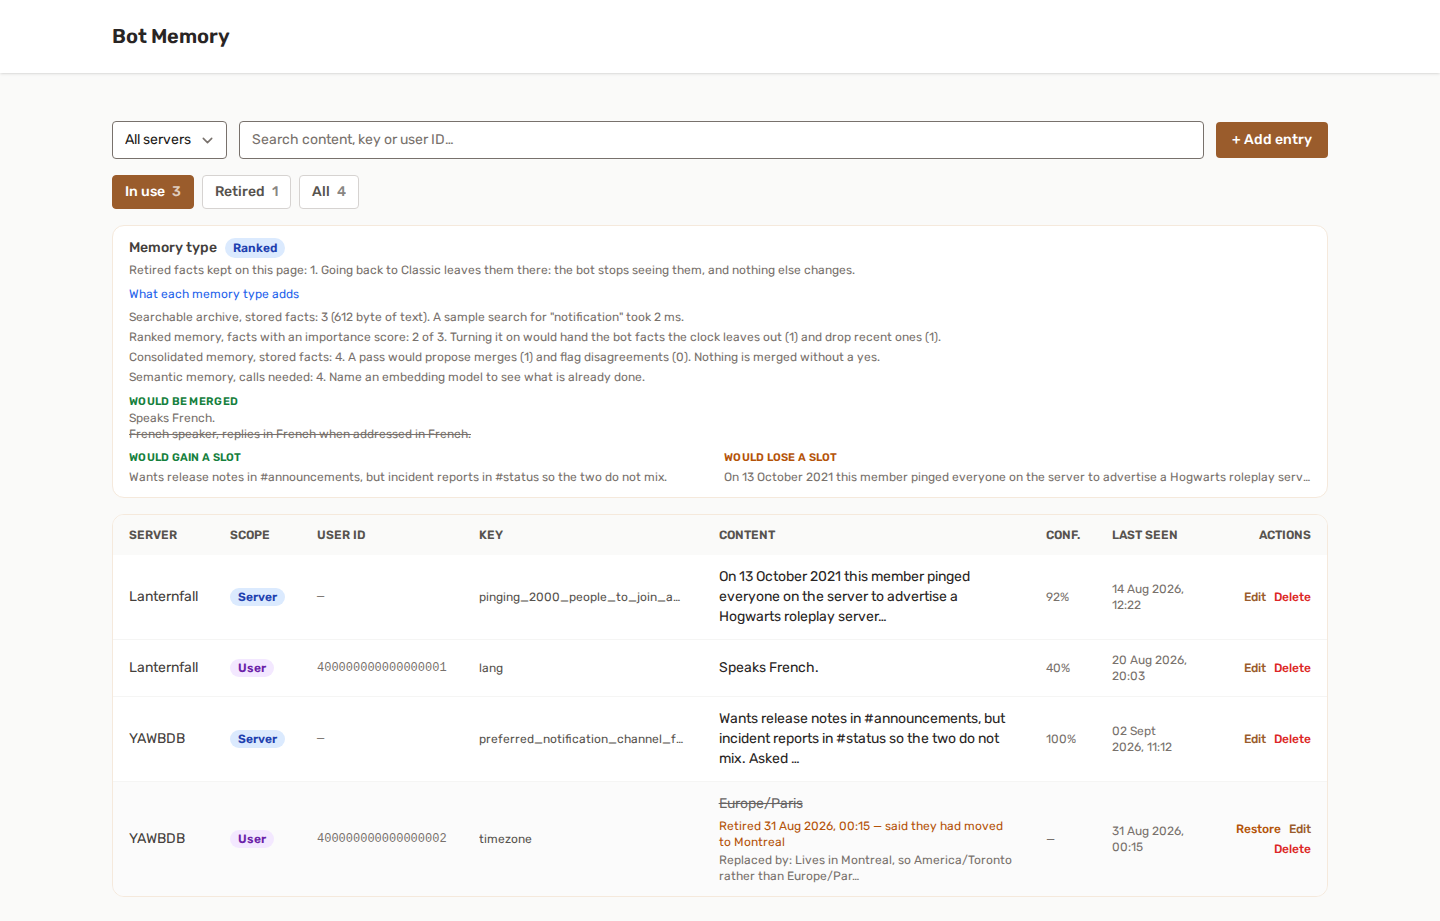
Die Speicherseite gibt berechtigten Personen einen vollständigen Überblick über die gespeicherten Einträge.
Auf dieser Seite kannst du:
- Speicher nach Server ansehen
- Nach Schlüssel oder Inhalt suchen
- Neue Einträge manuell hinzufügen
- Bestehende Einträge bearbeiten
- Veraltete Einträge löschen
- Sicherheitswerte (Konfidenz) prüfen
🔎 Filtern und Seitenaufteilung
Der Speicher lässt sich nach Server filtern und sofort durchsuchen.
Große Speicherbestände werden auf mehrere Seiten aufgeteilt, damit die Seite bedienbar bleibt.
✍️ Manuelle Speichereinträge
Du kannst Einträge manuell hinzufügen, wenn die KI etwas Bestimmtes wissen soll.
Beispiele:
server_theme: Dieser Server dreht sich um Retro-Gaming.bot_tone: Antworten sollen freundlich und knapp sein.important_rule: Gib im öffentlichen Kanal keinen Support; verweise Mitglieder auf Tickets.
Nutze kurze, klare Einträge. Vermeide riesige Textblöcke, wenn es nicht nötig ist.
✏️ Speicher bearbeiten
Du kannst Folgendes bearbeiten:
- Schlüssel
- Inhalt
- Konfidenz
Bearbeite einen Eintrag, wenn er noch nützlich ist, aber korrigiert werden muss.
Lösche ihn, wenn er veraltet ist oder nicht mehr relevant.
♻️ Nichts wird hinter deinem Rücken vergessen
Einträge werden nie automatisch entfernt. Es gibt kein Ablaufdatum und keinen Aufräumjob: Ein Fakt bleibt, bis der Bot selbst entscheidet, dass er nicht mehr gilt, oder bis jemand ihn auf dieser Seite entfernt.
Du steuerst, wie viel davon bei der KI ankommt. Maximale Anzahl eingefügter Speichereinträge auf der Einstellungsseite von AI-Antworten legt fest, wie viele Fakten als Kontext gesendet werden - von 1 bis 1000, standardmäßig 20. Ein höherer Wert gibt der KI mehr Material; ein niedrigerer hält die Antworten straffer. In beiden Fällen wird nichts gelöscht, du kannst den Wert also beliebig rauf- und runterschieben.
Alter ist kein Grund zu vergessen. Dieser Server spricht Französisch stimmt auch nach zwei Jahren noch, und niemand wird es erneut festhalten.
Wie der Bot entscheidet
Jeder Fakt, der an das Modell gesendet wird, trägt eine eigene Nummer, die im empfangenen Kontext als [#12] erscheint. Kommt der Bot zu dem Schluss, dass etwas nicht mehr gilt - eine geänderte Regel, eine zurückgenommene Vorliebe -, antwortet er mit dieser Nummer, und der Eintrag wird nicht mehr verwendet. Ob er gelöscht oder zum Nachlesen aufbewahrt wird, bestimmt der Speichertyp, siehe unten.
Er kann nur einen Fakt entfernen, der ihm in diesem Austausch tatsächlich gezeigt wurde. Nennt er eine Nummer, die nicht vor ihm lag, passiert nichts: Eine geratene Nummer kann keinen Fakt aus einem anderen Gespräch erreichen, selbst wenn es ihn auf demselben Server wirklich gibt.
Deshalb ist Maximale Anzahl eingefügter Speichereinträge doppelt wichtig. Ein Fakt, der das Modell nie erreicht, kann von ihm nie neu geprüft werden - er bleibt, bis ihn jemand auf dieser Seite entfernt. Beim durchsuchbaren Archiv ist das keine Sackgasse mehr: Ein Fakt, den der Bot nachschlägt, ist auch einer, den er korrigieren kann.
🧭 Einen Speichertyp wählen
Der Speichertyp ist eine Wahl pro Server, die auf dieser Speicherseite getroffen wird - nicht auf der Einstellungsseite von AI-Antworten. Er legt fest, wie der Bot ablegt, was er weiß, und wie er es wiederfindet, und wird gespeichert, sobald du klickst. Es ist keine Dropdown-Liste: Ein Klick öffnet die sechs Typen nebeneinander über der Seite, jeweils mit dem, was er tut, was er ändert, was ein Wechsel dorthin verschieben würde, und wo du mehr lesen kannst.
Oben auf der Seite sind die sechs Typen als eine Skala dargestellt, auf der die Position deines Servers markiert ist, noch bevor du die Auswahl öffnest.
Die Einstellungsseite von AI-Antworten enthält weiterhin die Einstellungen, die zum jeweils aktiven Typ gehören - die Gewichte des Rankings (Aktualität, Wichtigkeit, Relevanz), wie viele Fakten eingefügt werden und die Modelle für den Konsolidierungslauf im Hintergrund und für semantische Embeddings. Diese Seite sagt dir genau, wo sich was befindet, sodass du nie danach suchen musst.
Classic läuft heute und ist der Standard. Ein Server, der dieses Feld nie öffnet, verhält sich genau wie bisher: eine flache Liste von Fakten, die zuletzt aktualisierten werden in jede Antwort eingefügt, nichts wird von selbst entfernt.
Die anderen fünf fügen jeweils eine Sache zum vorherigen hinzu und werden der Reihe nach gebaut:
- Journal - jetzt verfügbar. Ein Fakt, der nicht mehr stimmt, wird zurückgezogen statt gelöscht, sodass du weiterhin nachlesen kannst, was er früher sagte. Siehe nächster Abschnitt.
- Durchsuchbares Archiv - jetzt verfügbar. Der Bot darf etwas nachschlagen, statt nur die Fakten zu nutzen, die ihm übergeben wurden, sodass das, was jenseits deines Limits für eingefügte Einträge liegt, nicht mehr unsichtbar ist. Siehe übernächster Abschnitt.
- Bewerteter Speicher - jetzt verfügbar. Die Plätze gehen an die nützlichsten Fakten statt nur an die zuletzt geänderten.
- Konsolidierter Speicher - jetzt verfügbar. Ein Hintergrunddurchlauf führt Duplikate zusammen und schreibt die Zusammenfassung neu, solange der Server ruhig ist, und schlägt dir jede dieser Änderungen zur Freigabe vor.
- Semantischer Speicher - Abgleich nach Bedeutung statt nach Wörtern, sodass „er spricht Französisch“ den Eintrag „die Serversprache ist Französisch“ findet. Der stärkste der sechs und der einzige, an dem eine Rechnung hängt.
Der eine Typ, der noch nicht bereit ist, ist im Dialog markiert und lässt sich nicht auswählen. Bei jedem Typ gelten dieselben zwei Regeln: Alle lesen denselben Speicher, und keiner löscht von selbst etwas - wenn du es dir anders überlegst und zurückwechselst, kostet dich das also nie einen Fakt.
Wenn ein Server ausgewählt ist, zeigt dir die Speicherseite vor der Änderung in Zahlen, was ein Wechsel tatsächlich verschieben würde.
📓 Journal - nichts wird gelöscht, nur zurückgezogen
Unter Journal löscht der Bot einen Fakt, den er für veraltet hält, nicht mehr. Der Gültigkeitszeitraum des Fakts endet einfach: Er verlässt den Kontext, den die KI erhält, und bleibt auf dieser Seite stehen, mit dem Datum, an dem er endete, und, falls es einen gibt, dem Fakt, der seinen Platz einnahm.
Dazu kommt auch die passende Möglichkeit. Statt nur [#12] fallen lassen zu können, kann der Bot sagen: „Dieser stimmt nicht mehr, das hier ersetzt ihn“ - und ihm wird ausdrücklich gesagt, dass die alte Formulierung erhalten bleibt. Eine Korrektur, die er für zerstörerisch hält, ist eine Korrektur, bei der er zögert.
Den Verlauf lesen
Sobald etwas zurückgezogen wurde, erscheinen über der Tabelle drei Tabs:
- In Kraft - was der Bot tatsächlich sehen kann. Das ist die Vorgabe und die eigentliche Antwort der Seite auf „Was weiß der Bot?“.
- Zurückgezogen - was früher galt. Durchgestrichen, mit Datum, dem Grund, falls der Bot einen angegeben hat, und dem Ersatz.
- Alle - beides in einer Liste.
Einen Fehlgriff rückgängig machen
Der Bot liegt manchmal falsch. Mit Wiederherstellen in einer zurückgezogenen Zeile öffnest du sie mit einem Klick wieder - genau deshalb wurde die Zeile aufbewahrt statt gelöscht. Der Ersatz, falls es einen gab, bleibt bewusst unangetastet: Zwei Fakten können gleichzeitig wahr sein, und welcher der beiden gehen muss, entscheidest du, nicht das Panel.
Löschen löscht weiterhin, in einer zurückgezogenen Zeile wie in jeder anderen. Wer einen Fakt von dieser Seite entfernt, hat entschieden; nichts stellt das infrage.
Wechseln und zurückwechseln
Das Aktivieren von Journal verschiebt nichts. Jeder Fakt, den du schon hast, gilt als weiterhin wahr - was er ohnehin schon war - und behält sein Erstellungsdatum.
Wenn du zu Classic zurückkehrst, bleibt alles, was in der Zwischenzeit zurückgezogen wurde, genau dort: weiterhin auf dieser Seite, weiterhin vom Bot nicht gesehen. Wenn du alles wieder vor die KI bringen willst, bietet die Speicherseite für diesen einen Server Alle zurückgezogenen Einträge wiederherstellen an und schreibt es in dein Aktivitätsprotokoll. Das geschieht nie automatisch: Was das Journal zurückgezogen hat, hat es aus gutem Grund zurückgezogen.
🔎 Durchsuchbares Archiv - der Bot kann etwas nachschlagen
Der klassische Speicher hat eine echte Grenze, und das ist nicht die Anzahl der Fakten, die du speichern darfst. Sie liegt darin, dass alles jenseits von Maximale Anzahl eingefügter Speichereinträge für die KI unsichtbar ist, so wahr es auch sein mag. Das Limit zu erhöhen ist der einzige Hebel, und er macht jede einzelne Nachricht teurer.
Das durchsuchbare Archiv gibt dem Bot den anderen Hebel. Die jüngsten Fakten bekommt er wie gewohnt, und zusätzlich darf er einen Fakt beim Namen anfordern - „durchsuche den Speicher nach: Pauls Geburtstag“. Was er findet, bekommt er, bevor er antwortet.
Was es kostet
Bei den Nachrichten, in denen der Bot nichts nachschlägt, also den meisten, nichts. Wenn er etwas nachschlägt, kostet es genau einen zusätzlichen Aufruf an die KI - die Frage wird mit den Fakten in der Hand noch einmal gestellt. Nie zwei: Ein Bot, der in seiner zweiten Antwort erneut um eine Suche bittet, wird ignoriert.
Die Suche selbst ist eine Volltextsuche, ausgeführt von der Datenbank. Keine Embeddings, keine Vektoren, nichts, was pro Nachricht berechnet wird, und kein Drittanbieter-Dienst.
Was er erreichen kann
Jeden Fakt dieses Servers, der noch in Kraft ist, in beiden Bereichen - Fakten über den Server und Fakten über seine Mitglieder. Das ist Absicht: „Pauls Geburtstag“ ist ein Fakt über jemanden, der nicht der Sprecher ist, und eine Suche, die nur die eigenen Fakten des Sprechers erreichen könnte, würde die meisten Fragen verfehlen, die sich zu stellen lohnen.
Was er nicht erreichen kann: alles, was unter einem Journal zurückgezogen wurde - das Fenster eines Fakts zu schließen ist genau die Entscheidung, ihn nicht wieder herauszugeben - und alles in einem Kanal, in dem Speicherlesen nicht erlaubt ist. Eine Suche ist ein Lesezugriff und folgt derselben Einstellung Kanäle, in denen der Speicher GELESEN werden darf.
Einen Fakt, den der Bot durch Suchen gefunden hat, darf er auch korrigieren, unter denselben Bedingungen wie bei den ihm übergebenen.
Bevor du wechselst: der Probelauf
Wenn ein Server ausgewählt ist, sagt dir die Speicherseite, was das Archiv dich kosten würde, in Zahlen aus deinen eigenen Daten: wie viele Fakten zu indizieren sind, wie viel Text das ist und wie lange eine echte Suche darüber gerade gedauert hat.
Das Aktivieren verschiebt nichts und schreibt nichts um. Der Index wird über den bereits gespeicherten Text aufgebaut und existiert für jeden Server, ob er sucht oder nicht - das Wechseln und Zurückwechseln geht also in beiden Richtungen sofort.
🏅 Bewerteter Speicher - die Plätze gehen an die Fakten, die sie verdienen
Der klassische Speicher gibt dem Modell die zuletzt geänderten N Fakten. Anders gesagt: Eine Regel, nach der dein Server seit einem Jahr lebt, verliert ihren Platz an den Smalltalk von gestern, weil der Smalltalk zuletzt angefasst wurde.
Der bewertete Speicher bewertet jeden Kandidaten nach drei Kriterien und liefert stattdessen die besten N:
- Wie aktuell er ist.
- Wie wichtig er ist - vom Modell in dem Moment bewertet, in dem es den Fakt schreibt, denn nur dann liegt der Grund für das Speichern noch vor ihm.
- Wie viel er mit dem zu tun hat, was gerade gesagt wird.
Es ist ein Ranking, kein Filter. Nichts wird dauerhaft beiseitegelegt, und ein Fakt, der bei einer Nachricht den Schnitt verfehlt, ist bei der nächsten wieder Kandidat.
Die Gewichte gehören dir
Drei Einstellungen auf der Seite von AI-Antworten - Aktualität, Wichtigkeit, Relevanz - legen pro Server fest, wie stark jedes Kriterium zählt. Ein Server, dessen Speicher überwiegend aus festen Regeln besteht, will, dass Wichtigkeit mehr wiegt als Frische; ein lebhafter Social-Server will das Gegenteil.
Die Konfidenz, die bereits bei jedem Fakt gespeichert ist, wird ebenfalls gelesen. Sie wirkt als Multiplikator, und nur nach unten: Ein Fakt, bei dem sich der Bot unsicher war, rangiert nicht vor einem, bei dem er sicher war.
Der Wechsel kostet nichts
Es gibt keine Migration und keine Rechnung. Ein Fakt, den noch niemand bewertet hat, wird in der Mitte eingeordnet statt ganz hinten, sodass das Ranking schon ab der ersten Nachricht mit dem arbeitet, was du bereits hast, und die Wichtigkeit sich von selbst füllt, während der Bot Fakten neu schreibt.
Der Probelauf sagt, wie viele deiner Fakten schon eine Bewertung tragen, und zeigt, welche einen Platz gewinnen und welche einen verlieren würden.
🧩 Konsolidierter Speicher - aufgeräumt wird, während der Server ruhig ist
Ein wachsender Speicher sagt am Ende dasselbe doppelt unter zwei Namen: language auf der einen Seite, lang auf der anderen. Bisher ging das nur von Hand.
Der konsolidierte Speicher fügt einen Hintergrunddurchlauf über den Speicher eines Servers hinzu, der ruhig geworden ist. Er läuft nie mitten in einer Antwort und - das ist das Wichtige - er wendet von selbst nichts an.
Er schlägt vor, du entscheidest
Der Durchlauf schreibt Vorschläge. Sie erscheinen einzeln auf der Speicherseite, der behaltene Fakt neben dem Fakt, den er ersetzen würde, und jeder hat drei Antworten:
- Zusammenführen - den Vorschlag des Durchlaufs übernehmen.
- Andersherum zusammenführen - stattdessen den anderen Fakt behalten. Bei zwei Fakten, die sich widersprechen, weißt du, welcher noch stimmt.
- Beide behalten - ablehnen. Der Durchlauf fragt nicht erneut, es sei denn, einer der beiden Fakten wird danach umgeschrieben.
Nichts ändert sich, bevor eine dieser Optionen angeklickt wird.
Ein Ja löscht nie
Ein Zusammenführen ist ein Ersatz im Sinne des Journals. Der Fakt, der Platz macht, schließt sein Fenster mit einem Verweis auf den, der geblieben ist, er erscheint auf dieser Seite durchgestrichen mit Datum und Grund, und Wiederherstellen holt ihn zurück. Ein Zusammenführen wird genau wie jede andere Zurückziehung rückgängig gemacht.
Widersprüche werden nie zusammengeführt. Zwei Fakten, die Gegensätzliches sagen, werden zur Klärung durch einen Menschen markiert. Nichts im Durchlauf weiß, welcher von beiden noch stimmt.
Die Zusammenfassung wird neu geschrieben
Die Zusammenfassung ist die eine Speicherzeile, die der Bot jedes Mal komplett liest - deshalb ist sie auch die Zeile, die als erste veraltet. Sie wurde einmal geschrieben, aus dem, was damals bekannt war.
Der Durchlauf entwirft aus den serverweiten Fakten, was er heute sagen würde, und die Seite stellt beide nebeneinander: Was der Bot heute liest und Was er stattdessen lesen würde. Dieselbe Regel wie beim Zusammenführen: Nichts ersetzt sie ohne ein Ja, und die vorherige Formulierung wird zurückgezogen statt gelöscht.
Sein eigenes Modell
Dieser Durchlauf läuft nicht im Wettlauf mit einer Discord-Antwort, daher kann er auf einem stärkeren oder günstigeren Modell laufen, das sich von dem unterscheidet, das im Kanal antwortet - mit eigenem Endpoint und eigenem Schlüssel, wie jedes Modellfeld im Panel.
Er funktioniert auch ganz ohne Modell. Ohne eines findet und schlägt der Durchlauf trotzdem jedes Paar vor; ein Zusammenführen behält dann einfach den gewinnenden Fakt wortgetreu, statt die beiden zu einem Satz umzuschreiben. Das Modell schreibt immer nur die vorgeschlagene Formulierung und den Entwurf der Zusammenfassung.
Wann er läuft
Nach eigenem Zeitplan, und er verweigert sich selbst, wenn sich ein Durchlauf nicht lohnen würde: ein Speicher, der zu klein für Duplikate ist, seit dem letzten Durchlauf nichts Neues, weniger als ein Tag seit dem letzten oder ein Vorschlag, der noch auf eine Antwort wartet. Ein Server, der nie ruhig ist, bekommt seinen Durchlauf nach einer Woche trotzdem, denn genau dessen Speicher füllt sich mit Duplikaten.
Bevor du wechselst: der Probelauf
Die Karte sagt dir anhand deiner eigenen Daten, wie viele Fakten gespeichert sind, wie viele Duplikate und wie viele Widersprüche ein Durchlauf finden würde, mit fünf echten Beispielen von deinem Server.
Das Aktivieren verschiebt nichts. Der erste Durchlauf schlägt vor; du entscheidest.
🧠 Semantischer Speicher - Bedeutung statt Wörter
Jeder Typ davor beantwortet im Kern dieselbe Frage: Haben diese beiden Texte Wörter gemeinsam? Bei „er spricht Französisch“ und „die Serversprache ist Französisch“ lautet die Antwort nein - ein gemeinsames Wort, und nicht das nützliche.
Der semantische Speicher macht aus jedem Fakt ein Embedding: eine Richtung statt einer Zeichenkette. Zwei Fakten mit derselben Bedeutung zeigen in dieselbe Richtung, egal mit welchen Wörtern sie geschrieben wurden, und die Nähe zwischen ihnen ist eine Zahl, die das Panel vergleichen kann.
Was sich tatsächlich ändert
Zwei Dinge, und das zweite spürst du jeden Tag.
Die Suche übersieht nichts mehr. Wenn der Bot nach einem Fakt sucht, der ihm nicht übergeben wurde, hängt er nicht mehr davon ab, dass das Mitglied dasselbe Wort benutzt hat wie die Person, die den Fakt notiert hat.
Das Ranking hängt nicht mehr von den Wörtern der Nachricht ab. Unter Ranked bewertet ein Fakt seine Relevanz danach, wo er in den Suchergebnissen gelandet ist. Unter Semantic wird danach bewertet, wie nah er tatsächlich an dem ist, was gerade gesagt wird - der Unterschied zwischen „dieser Fakt wurde gefunden“ und „dieser Fakt handelt davon“.
Was es kostet
Das ist der eine Typ, der deine Daten nach Zeitplan irgendwohin sendet, daher lohnt es sich, die Kosten klar zu benennen:
- Ein Embedding-Aufruf pro geschriebenem Fakt, einmalig. Ein Fakt, der nicht umformuliert wird, wird nie zweimal eingebettet.
- Ein Aufruf pro Nachricht, die lang genug ist, um verglichen zu werden. Unter zwölf Zeichen wird nichts gesendet - „lol“ hat nichts, womit man abgleichen könnte.
- Der Vergleich selbst findet im Panel statt, nicht in der Datenbank, weshalb der Typ bis zu einigen tausend Fakten pro Server gut funktioniert und nicht weit darüber hinaus.
Er braucht ein Embedding-Modell, benannt über denselben Endpoint und Schlüssel wie der Rest deiner KI-Einstellungen.
Er weicht von selbst aus
Kein Modell angegeben, ein Endpoint, der ablehnt, ein Nachholdurchlauf, der noch nicht gelaufen ist, oder ein gerade gewechseltes Embedding-Modell: In allen diesen Fällen greift die Suche wieder auf den Abgleich von Wörtern zurück, statt zu scheitern. Die Antwort sagt, welcher der beiden tatsächlich lief, sodass ein stiller Rückfall sichtbar bleibt.
Wenn du dein Embedding-Modell wechselst, wird alles neu eingebettet, und bis dieser Durchlauf fertig ist, sucht der Server nach Wörtern. In der Zwischenzeit geht nichts kaputt.
Bevor du wechselst: der Probelauf
Die Karte sagt dir, wie viele Aufrufe der Nachholdurchlauf machen würde, über wie viel Text, und welche deiner Fakten die Vektoren bereits für dieselbe Sache halten.
Kein Preis in einer Währung. Dort einen Betrag anzugeben hieße, für den genannten Endpoint einen Tarif zu erfinden, und eine ausgedachte Zahl auf einer Seite über Geld ist schlimmer als gar keine.
🧹 Speicher leeren
Einträge einzeln zu löschen ist richtig bei einem einzelnen falschen Fakt. Für zwei andere Fälle gibt es Speicher leeren, neben dem Serverfilter, sobald du einen Server ausgewählt hast:
- Alles über diesen Server - wenn der Speicher so weit abgedriftet ist, dass ein Neuanfang besser ist als zwanzig Korrekturen.
- Alles über ein Mitglied - wenn jemand gegangen ist oder darum bittet, vergessen zu werden. Gib seine Discord-Benutzer-ID ein.
Es geschieht sofort und lässt sich nicht rückgängig machen, und der Bot beginnt ab dem nächsten Gespräch wieder zu lernen. Jedes Leeren wird unter dem Namen der ausführenden Person in dein Aktivitätsprotokoll geschrieben, samt der Anzahl der entfernten Einträge.
🔑 Zugriffskontrolle
Speichereinträge sind für alle sichtbar, die Zugriff auf das Team haben, dem der Server gehört.
Sie zu ändern ist ein anderes Recht: Hinzufügen, Bearbeiten, Löschen und Leeren erfordern jeweils die Berechtigung, den Server zu konfigurieren - dieselbe, die die Funktionseinstellungen brauchen. Ohne sie kannst du die Liste weiterhin lesen, und die Schaltfläche „Speicher leeren“ fehlt einfach.
Speichere keine sensiblen Geheimnisse, Passwörter, privaten Tokens oder vertraulichen Informationen im AI-Speicher.
🧵 Threads
Das Lesen und Schreiben des Speichers folgt den Einstellungen Kanäle, in denen der Speicher GELESEN werden darf und Kanäle, in denen der Speicher GESCHRIEBEN werden darf, und ein Thread zählt nicht zu diesen Kanälen, auch wenn der Kanal, in dem er geöffnet wurde, dazugehört. Standardmäßig wird der Speicher in Threads weder gelesen noch geschrieben. Mit der Option Threads einbeziehen von AI-Antworten (standardmäßig deaktiviert) folgt ein Thread dem Kanal, in dem er gestartet wurde; siehe AI-Antworten. Lass sie ausgeschaltet, wenn ein Thread für Personen offen sein kann, die nicht sehen sollen, was der Speicher enthält.
✨ Speicher und Antwortqualität
Mehr Speicher ist nicht immer besser.
Zu viele irrelevante Fakten können die KI unfokussierter machen.
Guter Speicher sollte sein:
- Kurz
- Korrekt
- Relevant
- Aktuell
- Leicht verständlich
💡 Best Practices
- Prüfe den Speicher nach größeren Änderungen am Server.
- Lösche veraltete Fakten.
- Leere die Einträge eines Mitglieds, wenn es darum bittet, vergessen zu werden, statt nach seinen Zeilen zu suchen.
- Halte wichtige Regeln klar und eindeutig.
- Speichere keine privaten Nutzerdaten, es sei denn, du hast einen guten Grund und eine Erlaubnis.
- Nutze den Speicher, um den Kontext zu verbessern, nicht um Moderation oder das Urteil des Teams zu ersetzen.