La Memoria IA permite que YAWBDB guarde contexto útil de un servidor para que las respuestas de la IA sean más coherentes con el tiempo.
Dos fuentes escriben en ella: tú, desde el panel, y el bot, que anota lo que aprende de las conversaciones en Discord. El sistema de memoria se gestiona desde el panel, y nada de lo que contiene se elimina nunca de forma automática.
🧠 Para qué sirve la memoria
La memoria puede ayudar a la IA a recordar información como:
- El trasfondo del servidor
- Datos de la comunidad
- El tono preferido
- Bromas recurrentes
- Contexto de usuarios o roles
- Terminología propia del servidor
- Reglas o recordatorios importantes
El objetivo es que las respuestas de la IA den la impresión de conocer mejor el servidor.
📒 Página de memoria
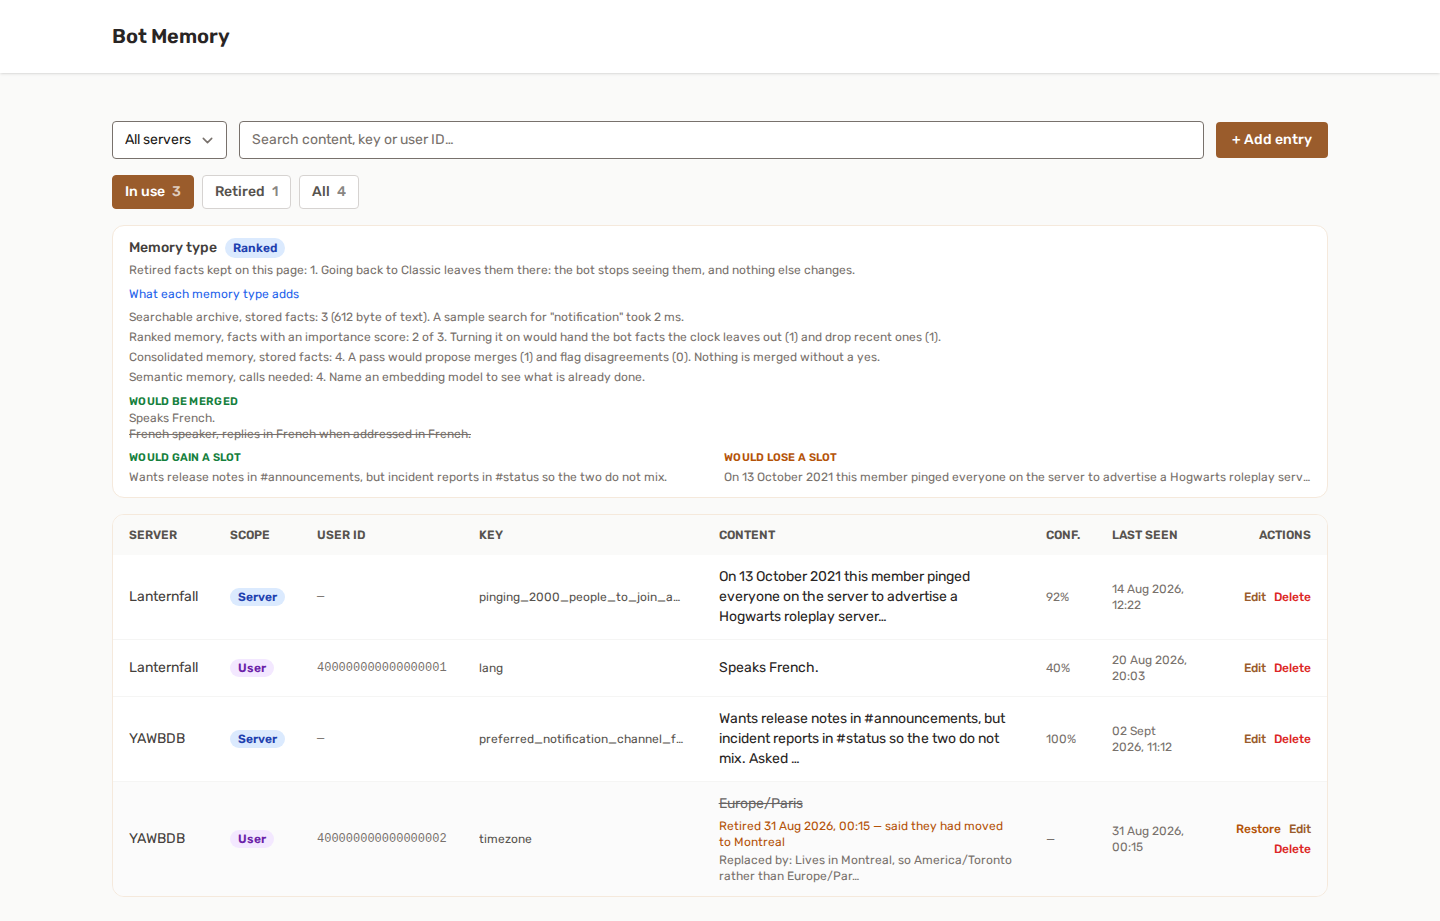
La página de Memoria ofrece a los usuarios autorizados una vista completa de las entradas de memoria guardadas.
Desde esta página puedes:
- Ver las memorias por servidor
- Buscar por clave o por contenido
- Añadir memorias nuevas manualmente
- Editar memorias existentes
- Eliminar memorias obsoletas
- Revisar los valores de confianza
🔎 Filtros y paginación
La memoria se puede filtrar por servidor y buscar al instante.
Los conjuntos de memoria grandes se paginan para que la página siga siendo manejable.
✍️ Entradas de memoria manuales
Puedes añadir entradas de memoria manualmente cuando quieras que la IA sepa algo concreto.
Ejemplos:
server_theme: Este servidor trata de videojuegos retro.bot_tone: Las respuestas deben ser amables y concisas.important_rule: No des soporte en canales públicos; dirige a los usuarios a los tickets.
Usa entradas cortas y claras. Evita volcar párrafos enormes salvo que sea necesario.
✏️ Editar la memoria
Puedes editar:
- La clave
- El contenido
- La confianza
Edita una memoria cuando siga siendo útil pero necesite una corrección.
Elimínala cuando esté obsoleta o ya no sea relevante.
♻️ Nada se olvida a tus espaldas
Las entradas nunca se eliminan automáticamente. No hay caducidad ni tarea de limpieza: un dato permanece hasta que el propio bot decide que ya no es válido, o hasta que alguien lo elimina desde esta página.
Lo que tú controlas es cuánto de todo eso llega a la IA. Máximo de entradas de memoria inyectadas, en la página de ajustes de Respuestas de IA, define cuántos datos se envían como contexto: de 1 a 1000, 20 por defecto. Subirlo le da más material a la IA; bajarlo hace las respuestas más ajustadas. En ningún caso se borra nada, así que puedes subirlo y bajarlo libremente.
La antigüedad no es un motivo para olvidar. Este servidor habla francés sigue siendo cierto dos años después, y nadie lo volverá a afirmar.
Cómo decide el bot
Cada dato enviado al modelo lleva su propio número, que aparece como [#12] en el contexto que recibe. Cuando el bot concluye que algo ya no es válido (una regla que cambió, una preferencia que alguien revirtió), responde con ese número y la entrada deja de usarse. Que se elimine o se conserve para consulta depende del tipo de memoria, más abajo.
Solo puede eliminar un dato que se le haya mostrado realmente en ese intercambio. Si nombra un número que no tenía delante, no pasa nada: un número adivinado no puede alcanzar un dato de otra conversación, ni siquiera uno real del mismo servidor.
Por eso Máximo de entradas de memoria inyectadas importa por partida doble. Un dato que nunca llega al modelo nunca puede ser reexaminado por él: se queda hasta que alguien lo elimina desde esta página. Con el archivo consultable eso deja de ser un callejón sin salida: un dato que el bot busca es también un dato que puede corregir.
🧭 Elegir un tipo de memoria
El tipo de memoria es una única elección por servidor, que se hace en esta página de Memoria (no en la página de ajustes de Respuestas de IA). Decide cómo guarda el bot lo que sabe y cómo lo recupera, y se guarda en el momento en que haces clic. No es un menú desplegable: al hacer clic se abren los seis tipos sobre la página, uno junto a otro, cada uno con lo que hace, lo que cambia, lo que movería pasarse a él y dónde leer más.
La parte superior de la página dibuja los seis tipos como una única escala, con la posición de tu servidor marcada, antes incluso de abrir el selector.
La página de ajustes de Respuestas de IA sigue conteniendo los ajustes que acompañan al tipo activo: los pesos de la clasificación (lo reciente, la importancia, la relevancia), cuántos datos se inyectan, y los modelos usados para el proceso de consolidación en segundo plano y para los embeddings semánticos. Esta página te dice exactamente dónde está cada uno, para que nunca tengas que buscarlos.
Classic es lo que funciona hoy y es el valor por defecto. Un servidor que nunca abre este campo se comporta exactamente como siempre: una lista plana de datos, los actualizados más recientemente se inyectan en cada respuesta y nada se elimina por sí solo.
Los otros cinco añaden cada uno una cosa sobre el anterior, y se están construyendo en orden:
- Diario: disponible ahora. Un dato que deja de ser cierto se retira en lugar de borrarse, así que todavía puedes leer lo que decía. Consulta la sección siguiente.
- Archivo consultable: disponible ahora. El bot puede buscar algo en lugar de usar solo los datos que se le entregaron, de modo que lo que queda más allá de tu límite de inyección deja de ser invisible. Consulta la sección posterior a la siguiente.
- Memoria clasificada: disponible ahora. Los huecos van a los datos más útiles y no simplemente a los más recientes.
- Memoria consolidada: disponible ahora. Un proceso en segundo plano junta los duplicados y reescribe el resumen mientras el servidor está tranquilo, y te propone cada cambio para que lo apruebes.
- Memoria semántica: busca por significado en lugar de por palabras, de modo que «habla francés» encuentra «el idioma del servidor es el francés». El más potente de los seis, y el único con una factura asociada.
El tipo que todavía no está listo aparece marcado en el cuadro de diálogo y no se puede seleccionar. Sea cual sea el tipo, se cumplen siempre las mismas dos reglas: todos leen la misma memoria y ninguno elimina nada por sí solo, así que cambiar de opinión, y volver atrás, nunca te cuesta un dato.
Con un servidor elegido, la página de memoria te dice, con cifras, lo que un cambio movería realmente, antes de que lo hagas.
📓 Diario: nada se borra, solo se retira
Con Diario, el bot ya no elimina un dato que considera desactualizado. Simplemente termina su periodo de validez: sale del contexto que se le da a la IA y permanece en esta página con la fecha en que dejó de valer y, cuando existe, el dato que ocupó su lugar.
También gana el movimiento que lo acompaña. En lugar de poder solo descartar [#12], el bot puede decir «este ya no es cierto, esto es lo que lo sustituye», y se le dice, con todas las letras, que la redacción antigua se conserva. Una corrección que cree destructiva es una corrección que duda en hacer.
Leer el historial
Cuando algo se ha retirado, aparecen tres pestañas sobre la tabla:
- En vigor: lo que el bot puede ver realmente. Es la pestaña por defecto y la respuesta real de la página a «¿qué sabe el bot?».
- Retirados: lo que antes era cierto. Tachados, con la fecha, el motivo si el bot lo dio y el dato sustituto.
- Todo: ambos, en una sola lista.
Deshacer un error
El bot se equivoca a veces. Restaurar, en una fila retirada, la reabre con un clic: esa es la razón por la que la fila se conservó en lugar de borrarse. El sustituto, si lo había, se deja deliberadamente como está: dos datos pueden ser ciertos a la vez, y cuál de los dos se queda lo decides tú, no el panel.
Eliminar sigue eliminando, tanto en una fila retirada como en cualquier otra. Una persona que quita un dato desde esta página ya ha decidido; nada lo pone en duda.
Cambiar y volver
Activar Diario no mueve nada. Todos los datos que ya tienes cuentan como todavía ciertos (que es lo que ya eran) y conservan su fecha de creación.
Volver a Classic deja lo que se retiró mientras tanto exactamente donde está: sigue en esta página, sigue sin que el bot lo vea. Si quieres que todo vuelva a estar delante de la IA, la página de memoria ofrece Restaurar todos los datos retirados para ese servidor, y lo registra en tu registro de auditoría. Nunca se hace por ti: lo que el diario retiró, lo retiró por una razón.
🔎 Archivo consultable: el bot puede buscar cosas
La memoria Classic tiene un límite real, y no es el número de datos que puedes guardar. Es que todo lo que supera Máximo de entradas de memoria inyectadas es invisible para la IA, por cierto que sea. Subir el límite es la única palanca, y encarece cada mensaje.
El archivo consultable le da al bot la otra palanca. Los datos recientes se le entregan como de costumbre y, además, puede pedir uno por su nombre: «busca en la memoria: el cumpleaños de Paul». Lo que encuentra se le entrega antes de responder.
Lo que cuesta
Nada en los mensajes en los que el bot no busca nada, que son la mayoría. Cuando sí busca algo, cuesta exactamente una llamada extra a la IA: se vuelve a hacer la pregunta con los datos a mano. Nunca dos: si el bot pide buscar otra vez en su segunda respuesta, se ignora.
La búsqueda en sí es de texto completo, ejecutada por la base de datos. Sin embeddings, sin vectores, nada calculado por mensaje y sin ningún servicio de terceros.
A qué puede acceder
A todos los datos de ese servidor que sigan en uso, en los dos ámbitos: los datos sobre el servidor y los datos sobre sus miembros. Es deliberado: «el cumpleaños de Paul» es un dato sobre alguien que no es quien habla, y una búsqueda que solo pudiera alcanzar los datos de quien habla perdería la mayoría de las preguntas que merece la pena hacer.
A lo que no puede acceder: a nada retirado en un diario (cerrar la ventana de un dato es justamente la decisión de no devolverlo) ni a nada en un canal donde no se permite leer la memoria. Una búsqueda es una lectura y obedece al mismo ajuste de Canales donde se puede LEER la memoria.
Un dato que el bot encontró buscando es también uno que puede corregir, en las mismas condiciones que los que se le entregaron.
Antes de cambiar: la simulación
Con un servidor elegido, la página de memoria te dice lo que te costaría el archivo, con números sacados de tus propios datos: cuántos datos hay que indexar, cuánto texto es y cuánto tardó una búsqueda real sobre ellos.
Activarlo no mueve ni reescribe nada. El índice se construye sobre el texto que ya está guardado, y existe para todos los servidores, busquen o no, así que cambiar y volver atrás es instantáneo en ambos sentidos.
🏅 Memoria clasificada: los huecos van a los datos que los merecen
La memoria Classic le entrega al modelo los últimos N datos modificados. Dicho de otro modo: una regla por la que tu servidor se rige desde hace un año pierde su sitio frente a la charla trivial de ayer, porque esa charla se tocó más recientemente.
La memoria clasificada puntúa cada dato candidato según tres criterios y entrega los N mejores:
- Cuán reciente es.
- Cuán importante es: lo puntúa el modelo en el momento en que escribe el dato, que es el único momento en que todavía tiene delante la razón para guardarlo.
- Cuánto tiene que ver con lo que se está diciendo ahora mismo.
Es una clasificación, no un filtro. Nada se aparta para siempre, y un dato que no entra en el corte en un mensaje vuelve a ser candidato en el siguiente.
Los pesos son tuyos
Tres ajustes de la página de Respuestas de IA (lo reciente, la importancia, la relevancia) deciden cuánto cuenta cada criterio, por servidor. Un servidor cuya memoria sean sobre todo reglas permanentes querrá que la importancia pese más que la novedad; un servidor social muy activo querrá lo contrario.
También se lee la confianza ya guardada con cada dato. Actúa como multiplicador, y solo hacia abajo: un dato del que el bot no estaba seguro no supera a otro del que sí lo estaba.
Cambiar no cuesta nada
No hay migración ni factura. Un dato que nadie ha puntuado todavía se clasifica en el medio y no al final, así que la clasificación funciona desde el primer mensaje con lo que ya tienes, y la importancia se completa sola a medida que el bot reescribe datos.
La simulación indica cuántos de tus datos ya llevan una puntuación, y muestra cuáles ganarían un hueco y cuáles lo perderían.
🧩 Memoria consolidada: el orden se hace mientras el servidor está tranquilo
Una memoria que crece acaba diciendo lo mismo dos veces con dos nombres: language por un lado, lang por otro. Hasta ahora, la única forma de resolverlo era a mano.
La memoria consolidada añade un proceso en segundo plano sobre la memoria de un servidor que se ha quedado tranquilo. Nunca se ejecuta en mitad de una respuesta y, y esto es lo importante, no aplica nada por sí solo.
Propone, tú decides
El proceso escribe propuestas. Aparecen en la página de memoria una por una, con el dato que se conservaría junto al dato que sustituiría, y cada una tiene tres respuestas:
- Fusionar: aceptar la sugerencia del proceso.
- Fusionar al revés: conservar el otro dato. Con dos datos que se contradicen, eres tú quien sabe cuál sigue siendo cierto.
- Conservar ambos: rechazar. El proceso no volverá a preguntar, salvo que uno de los dos datos se reescriba después.
No cambia nada hasta que se hace clic en una de ellas.
Un sí nunca borra
Una fusión es una sustitución en el sentido del diario. El dato que se aparta cierra su ventana señalando al que se queda, aparece tachado en esta página con su fecha y su motivo, y Restaurar lo trae de vuelta. Una fusión se deshace exactamente como cualquier otra retirada.
Las contradicciones nunca se fusionan. Dos datos que dicen cosas opuestas se marcan para que una persona los resuelva. Nada en el proceso sabe cuál de los dos sigue siendo cierto.
El resumen se reescribe
El resumen es la única fila de memoria que el bot lee entera, cada vez, así que también es la que se queda anticuada antes. Se escribió una vez, con lo que se sabía entonces.
El proceso redacta lo que diría hoy a partir de los datos de todo el servidor, y la página pone ambos lado a lado: lo que tu bot lee hoy y lo que leería en su lugar. Misma regla que en una fusión: nada lo sustituye sin un sí, y la redacción anterior se retira en lugar de borrarse.
Su propio modelo
Este proceso no compite con una respuesta de Discord, así que puede ejecutarse con un modelo más potente, o más barato, distinto del que responde en el canal, con su propio endpoint y su propia clave, como todos los campos de modelo del panel.
También funciona sin ningún modelo. Sin uno, el proceso sigue encontrando y proponiendo todos los pares; una fusión simplemente conserva el dato ganador palabra por palabra en lugar de reescribir los dos en una sola frase. El modelo solo escribe la redacción sugerida y el borrador del resumen.
Cuándo se ejecuta
Con su propio calendario, y se niega a ejecutarse cuando no merecería la pena: una memoria demasiado pequeña para tener duplicados, nada cambiado desde el último proceso, menos de un día desde el último, o una propuesta que ya espera respuesta. Un servidor que nunca está tranquilo recibe su proceso igualmente pasada una semana, porque es justo el servidor cuya memoria se llena de duplicados.
Antes de cambiar: la simulación
La tarjeta te dice, con tus propios datos, cuántos datos hay guardados, cuántos duplicados y cuántas contradicciones encontraría un proceso, con cinco ejemplos reales de tu servidor.
Activarlo no mueve nada. El primer proceso propone; tú decides.
🧠 Memoria semántica: significado en lugar de palabras
Todos los tipos anteriores responden en el fondo a la misma pregunta: ¿estos dos textos comparten palabras? Para «habla francés» y «el idioma del servidor es el francés», la respuesta es no: una palabra en común, y no es la útil.
La memoria semántica convierte cada dato en un embedding: una dirección en lugar de una cadena de texto. Dos datos que significan lo mismo apuntan en la misma dirección, sean cuales sean las palabras con que se escribieron, y la cercanía entre ellos es un número que el panel puede comparar.
Qué cambia realmente
Dos cosas, y la segunda es la que notas cada día.
La búsqueda deja de dejarse cosas. Cuando el bot busca un dato que no se le entregó, deja de depender de que el miembro haya usado la misma palabra que quien anotó el dato.
La clasificación deja de depender de las palabras del mensaje. Con Clasificada, un dato puntúa su relevancia según el lugar en que quedó entre los resultados de la búsqueda. Con Semántica puntúa según lo cerca que está realmente de lo que se dice: la diferencia entre «este dato se encontró» y «este dato trata de esto».
Lo que cuesta
Este es el único tipo que envía tus datos a algún sitio de forma periódica, así que conviene decir claramente el coste:
- Una llamada de embedding por dato escrito, una sola vez. Un dato que no se reformula nunca se vuelve a incrustar.
- Una llamada por mensaje lo bastante largo como para clasificarse. Por debajo de doce caracteres no se envía nada: «lol» no tiene nada con lo que coincidir.
- La comparación en sí se hace en el panel, no en la base de datos, y por eso el tipo funciona cómodamente hasta unos pocos miles de datos por servidor y no mucho más allá.
Necesita un modelo de embeddings, indicado en el mismo endpoint y con la misma clave que el resto de tus ajustes de IA.
Recurre a la alternativa por sí solo
Si no se indica ningún modelo, si un endpoint rechaza la petición, si un proceso de puesta al día todavía no se ha ejecutado o si acabas de cambiar de modelo de embeddings, en todos esos casos la búsqueda vuelve a coincidir por palabras en lugar de fallar. La respuesta indica cuál de las dos se ejecutó realmente, de modo que una alternativa silenciosa sigue siendo visible.
Cambiar tu modelo de embeddings vuelve a incrustar todo, y hasta que ese proceso termine el servidor busca por palabras. Nada se rompe mientras tanto.
Antes de cambiar: la simulación
La tarjeta te dice cuántas llamadas haría el proceso de puesta al día, sobre cuánto texto, y cuáles de tus datos los vectores ya consideran lo mismo.
Ningún precio en moneda. Poner una cifra supondría inventar una tarifa para el endpoint que hayas indicado, y un número inventado en una página sobre dinero es peor que ningún número.
🧹 Borrar la memoria
Eliminar entradas una a una es lo adecuado para un único dato erróneo. Para otros dos casos existe Borrar la memoria, junto al filtro de servidor una vez que has elegido un servidor:
- Todo sobre este servidor: cuando la memoria se ha desviado tanto que empezar de cero compensa más que veinte correcciones.
- Todo sobre un miembro: cuando alguien se ha ido o pide que lo olviden. Introduce su id de usuario de Discord.
Es inmediato y no se puede deshacer, y el bot vuelve a aprender desde la siguiente conversación. Cada borrado se registra en tu registro de auditoría con el nombre de quien lo hizo y cuántas entradas se fueron.
🔑 Control de acceso
Las entradas de memoria son visibles para cualquiera con acceso al equipo propietario del servidor.
Modificarlas es otro derecho: añadir, editar, eliminar y borrar requieren todos permiso para configurar el servidor, el mismo que necesitan los ajustes de las funciones. Sin él, la lista sigue siendo tuya para leerla, y el botón Borrar la memoria simplemente no aparece.
No guardes secretos sensibles, contraseñas, tokens privados ni información confidencial en la memoria IA.
🧵 Hilos
La lectura y la escritura de memoria siguen los ajustes Canales donde se puede LEER la memoria y Canales donde se puede ESCRIBIR la memoria, y un hilo no es uno de esos canales, ni siquiera cuando el canal donde se abrió lo es. Por defecto, la memoria no se lee ni se escribe en los hilos. La opción Incluir hilos de Respuestas de IA (desactivada por defecto) permite que un hilo siga al canal donde se creó; consulta Respuestas de IA. Mantenla desactivada si un hilo puede estar abierto a personas que no deberían ver lo que contiene la memoria.
✨ Memoria y calidad de las respuestas
Más memoria no siempre es mejor.
Demasiados datos irrelevantes pueden hacer que la IA se centre menos.
Una buena memoria debe ser:
- Breve
- Precisa
- Relevante
- Actualizada
- Fácil de entender
💡 Buenas prácticas
- Revisa la memoria después de cambios importantes en el servidor.
- Elimina los datos obsoletos.
- Borra las entradas de un miembro cuando te pida que lo olvides, en lugar de buscar sus filas una por una.
- Mantén las reglas importantes claras y explícitas.
- No guardes datos privados de usuarios salvo que tengas un buen motivo y permiso.
- Usa la memoria para mejorar el contexto, no para sustituir la moderación ni el criterio del personal.