AudioToText converte l'audio in testo tramite trascrizione.
È separato dalla registrazione completa dei canali vocali e si usa quando il tuo server ha bisogno di convertire messaggi o file audio in testo leggibile.
🎙️ Cosa fa AudioToText
AudioToText prende un input audio supportato e genera una trascrizione.
Può essere utile per:
- Accessibilità
- Revisione per la moderazione
- Appunti delle riunioni
- Riepiloghi dei messaggi vocali
- Archivi ricercabili
⚙️ Configurazione
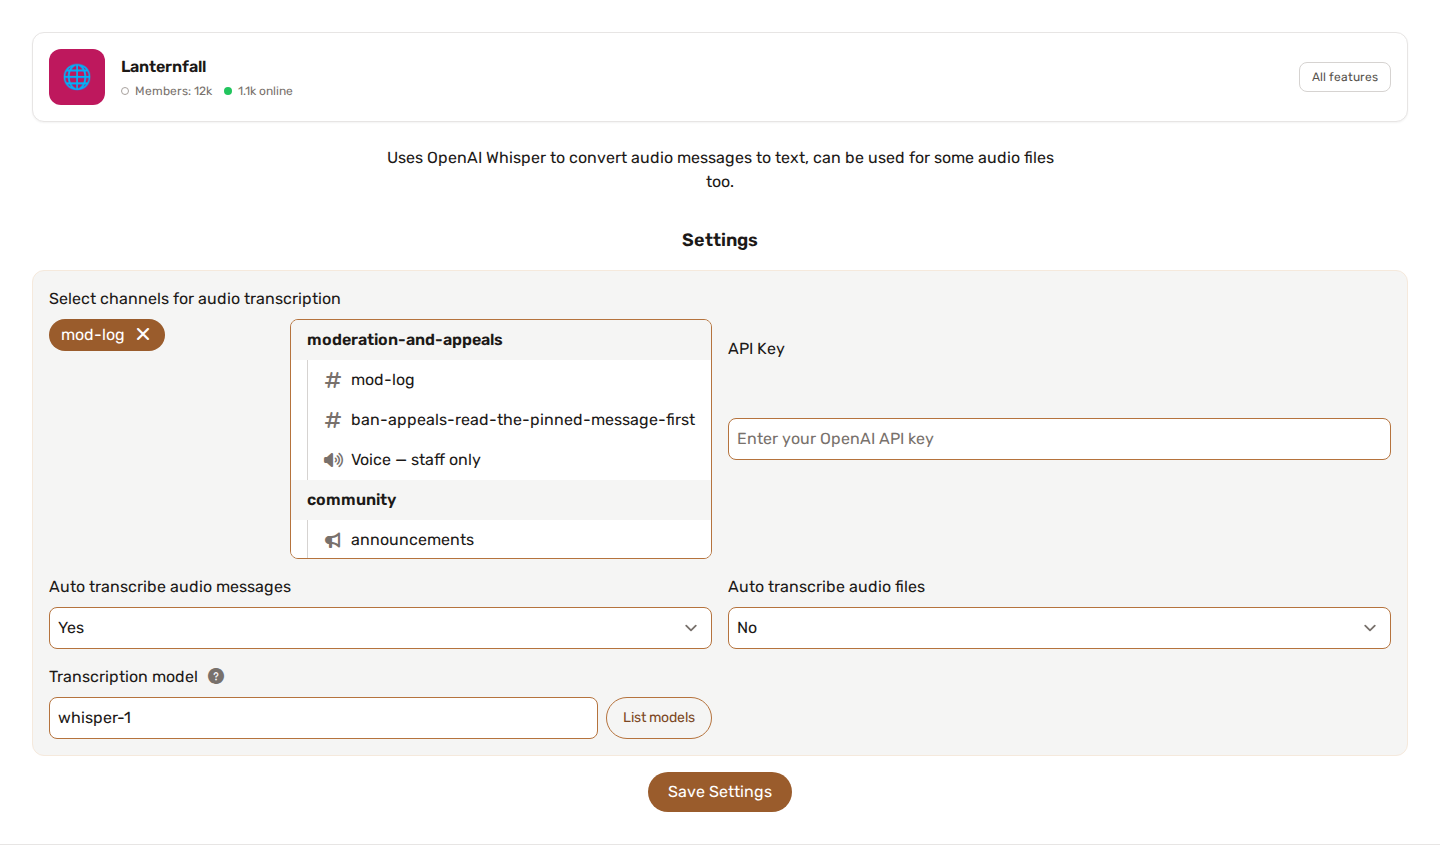
A seconda della configurazione del tuo server, AudioToText può richiedere:
- Un canale in cui l'audio viene elaborato
- Una chiave API
- Un modello di trascrizione
- Un endpoint di trascrizione personalizzato (facoltativo)
- Restrizioni per ruolo o canale
🔌 Endpoint di trascrizione personalizzato
AudioToText può usare un endpoint di trascrizione personalizzato compatibile con Whisper.
È utile se vuoi usare un tuo provider o un servizio di trascrizione self-hosted.
Per maggiori dettagli vedi Custom AI Model Endpoints.
🧠 Scegliere il modello di trascrizione
Il campo Modello di trascrizione elenca i modelli che il tuo endpoint pubblica davvero - il pannello lo interroga, invece di mostrare un elenco scritto a memoria - e tiene solo quelli in grado di trascrivere.
Lascialo vuoto e viene usato whisper-1, che è ciò che offre OpenAI. Se punti AudioToText al tuo server, questo è il campo che conta: un'istanza faster-whisper o distil-whisper raramente risponde al nome whisper-1, e chiederle un modello che non ha è il motivo più comune per cui un endpoint self-hosted non restituisce nulla.
↔️ Differenza rispetto alla registrazione audio
AudioToText si concentra sulla trascrizione.
La registrazione audio si concentra sulla registrazione delle conversazioni nei canali vocali e può aggiungere, facoltativamente, trascrizione e riepiloghi.
Usa AudioToText quando ti serve soprattutto convertire audio in testo. Usa la registrazione audio quando devi catturare un'intera sessione di un canale vocale.
💡 Buone pratiche
- Prova prima con audio brevi.
- Assicurati che il formato del file sia supportato.
- Usa audio chiaro per ottenere risultati migliori.
- Evita di usare la trascrizione per audio privato sensibile, a meno che il tuo server non abbia una politica chiara.
- Rivedi le trascrizioni prima di fare affidamento su di esse per la moderazione o per appunti ufficiali.