AudioToText convertit de l’audio en texte grâce à la transcription.
Cette fonctionnalité est distincte de l’enregistrement complet des salons vocaux, et peut servir quand ton serveur a besoin que des messages ou fichiers audio soient convertis en texte lisible.
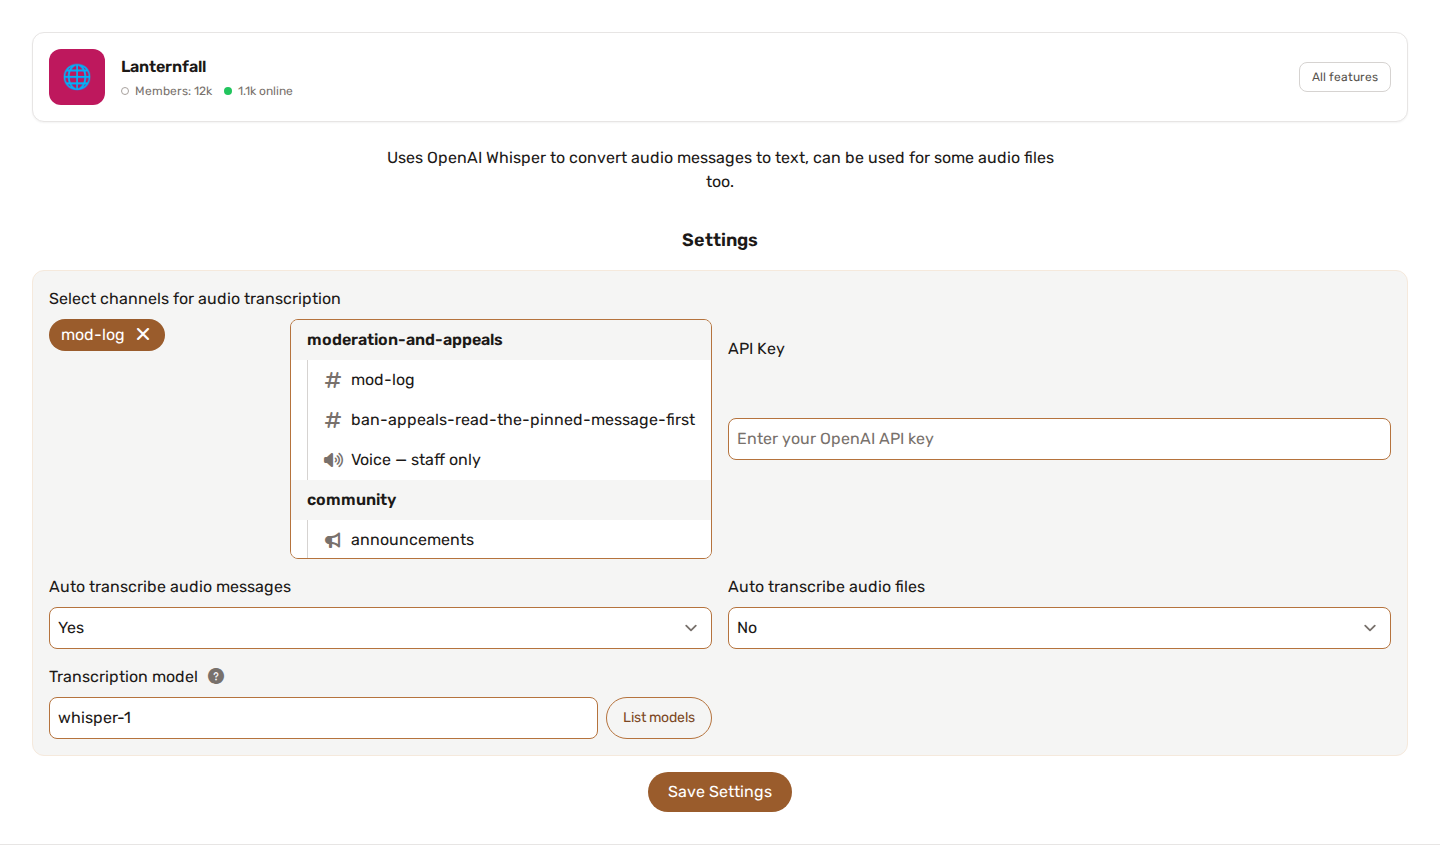
🎙️ Ce que fait AudioToText
AudioToText prend en entrée un audio pris en charge et génère une transcription.
Cela peut aider pour :
- L’accessibilité
- La relecture de modération
- Les notes de réunion
- Les résumés de messages vocaux
- Des archives où l’on peut chercher
⚙️ Configuration
Selon la configuration de ton serveur, AudioToText peut demander :
- Un salon où l’audio est traité
- Une clé API
- Un modèle de transcription
- Un point d’accès de transcription personnalisé, facultatif
- Des restrictions par rôle ou par salon
🔌 Point d’accès de transcription personnalisé
AudioToText peut utiliser un point d’accès de transcription personnalisé compatible Whisper.
C’est utile si tu veux utiliser ton propre fournisseur ou un service de transcription auto-hébergé.
Consulte Custom AI Model Endpoints pour plus de détails.
🧠 Choisir le modèle de transcription
Le champ Modèle de transcription liste les modèles que ton point d’accès publie réellement - le panel lui pose la question, au lieu d’afficher une liste écrite de mémoire - et ne garde que ceux qui savent transcrire.
Laisse-le vide et whisper-1 est utilisé, c’est ce que sert OpenAI. Si tu pointes AudioToText vers ton propre serveur, c’est ce champ qui compte : une instance faster-whisper ou distil-whisper répond rarement au nom whisper-1, et lui demander un modèle qu’elle n’a pas est la raison habituelle pour laquelle un point d’accès auto-hébergé ne renvoie rien.
↔️ Différence avec l’enregistrement audio
AudioToText se concentre sur la transcription.
L’enregistrement audio se concentre sur l’enregistrement des conversations des salons vocaux, et peut en option ajouter la transcription et des résumés.
Utilise AudioToText quand tu as surtout besoin de convertir de l’audio en texte. Utilise l’enregistrement audio quand tu as besoin de capturer toute une session d’un salon vocal.
💡 Bonnes pratiques
- Commence par tester avec un audio court.
- Vérifie que le format de fichier est pris en charge.
- Utilise un audio clair pour de meilleurs résultats.
- Évite d’utiliser la transcription pour des audios privés sensibles, sauf si ton serveur a une politique claire.
- Relis les transcriptions avant de t’y fier pour la modération ou des notes officielles.