La mémoire IA permet à YAWBDB de stocker un contexte utile pour un serveur, afin que les réponses de l’IA gagnent en cohérence avec le temps.
Deux sources y écrivent : toi, depuis le panel, et le bot, qui note ce qu’il apprend des conversations sur Discord. Le système de mémoire se gère depuis le panel, et rien n’y est jamais supprimé automatiquement.
🧠 À quoi sert la mémoire
La mémoire peut aider l’IA à retenir des informations comme :
- Le lore du serveur
- Des faits sur la communauté
- Le ton préféré
- Les blagues récurrentes
- Le contexte d’un utilisateur ou d’un rôle
- La terminologie propre au serveur
- Des règles ou des rappels importants
Le but est que les réponses de l’IA donnent l’impression de mieux connaître le serveur.
📒 Page Mémoire
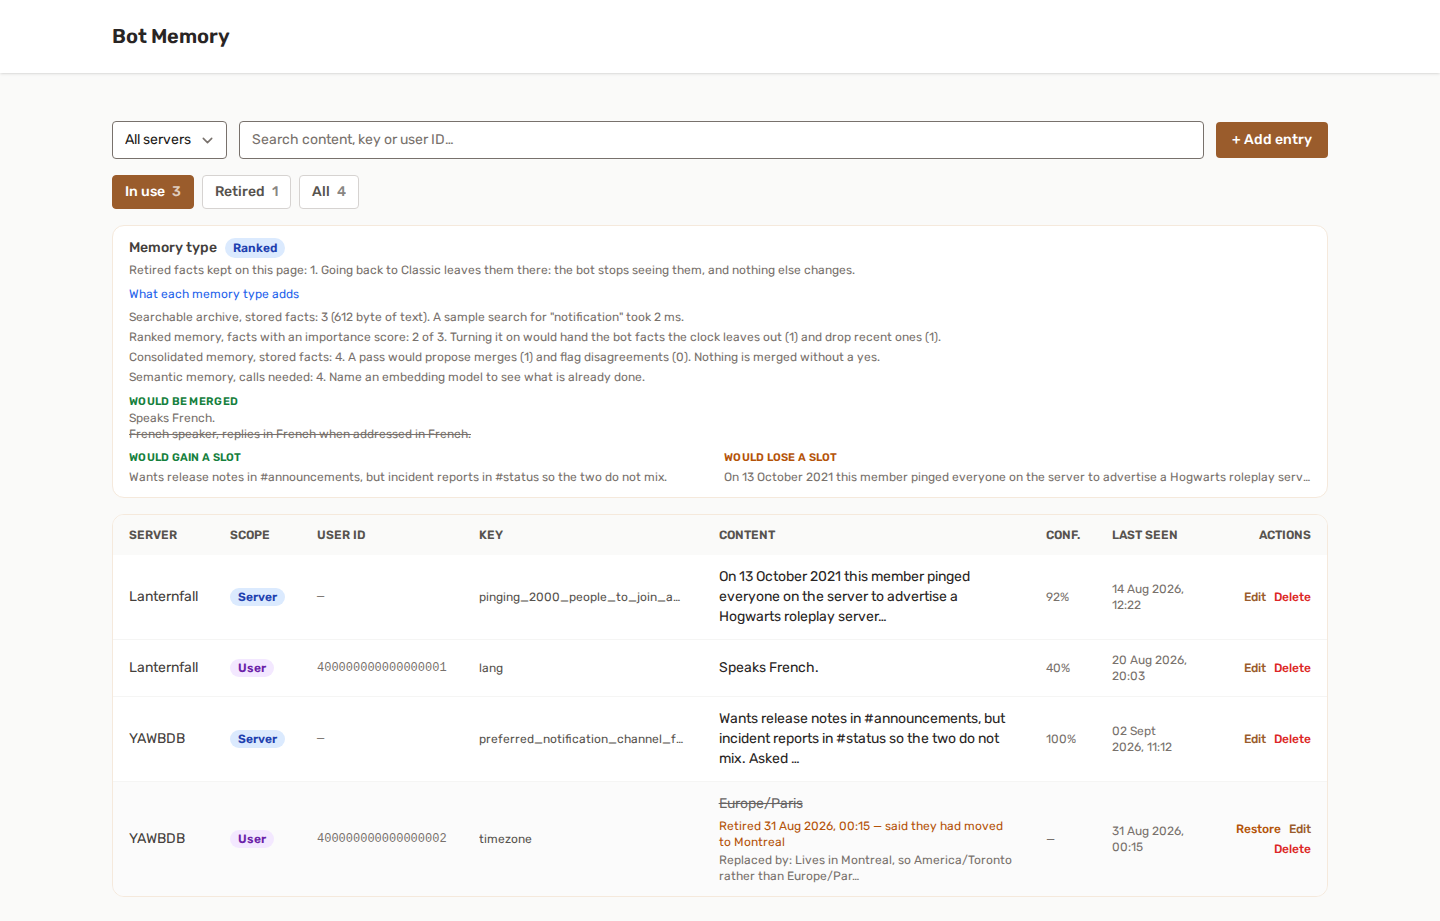
La page Mémoire offre aux utilisateurs autorisés une vue complète des entrées stockées.
Depuis cette page, tu peux :
- Voir les souvenirs par serveur
- Chercher par clé ou par contenu
- Ajouter de nouveaux souvenirs manuellement
- Modifier les souvenirs existants
- Supprimer les souvenirs périmés
- Consulter les valeurs de confiance
🔎 Filtrage et pagination
La mémoire peut être filtrée par serveur et consultée avec une recherche instantanée.
Les grands ensembles de souvenirs sont paginés pour que la page reste utilisable.
✍️ Entrées de mémoire manuelles
Tu peux ajouter des entrées de mémoire manuellement quand tu veux que l’IA sache quelque chose de précis.
Exemples :
server_theme: Ce serveur parle de jeux rétro.bot_tone: Les réponses doivent être amicales et concises.important_rule: Ne pas donner de support dans les salons publics ; orienter les utilisateurs vers les tickets.
Utilise des entrées courtes et claires. Évite de déverser d’énormes paragraphes sauf si c’est nécessaire.
✏️ Modifier la mémoire
Tu peux modifier :
- La clé
- Le contenu
- La confiance
Modifie un souvenir quand il est toujours utile mais qu’il demande une correction.
Supprime-le quand il est périmé ou qu’il n’a plus de raison d’être.
♻️ Rien n’est oublié dans ton dos
Les entrées ne sont jamais supprimées automatiquement. Il n’y a ni expiration ni tâche de nettoyage : un fait reste jusqu’à ce que le bot lui-même décide qu’il ne tient plus, ou jusqu’à ce que quelqu’un le supprime depuis cette page.
Ce que tu contrôles, c’est la quantité qui parvient à l’IA. Nombre maximum de souvenirs injectés, dans la page de réglages d’AI Response, fixe combien de faits sont envoyés comme contexte : de 1 à 1000, 20 par défaut. L’augmenter donne plus de matière à l’IA ; le diminuer rend les réponses plus resserrées. Rien n’est supprimé dans les deux cas : tu peux donc le monter et le descendre librement.
L’ancienneté n’est pas une raison d’oublier. Ce serveur parle français reste vrai deux ans plus tard, et personne ne le redira.
Comment le bot décide
Chaque fait envoyé au modèle porte son propre numéro, affiché sous la forme [#12] dans le contexte qu’il reçoit. Quand le bot conclut que quelque chose ne tient plus (une règle qui a changé, une préférence que quelqu’un a inversée), il répond avec ce numéro, et l’entrée cesse d’être utilisée. Qu’elle soit supprimée ou conservée en lecture, c’est le type de mémoire qui le décide, plus bas.
Il ne peut retirer qu’un fait qu’on lui a réellement montré dans cet échange. S’il cite un numéro qui n’était pas devant lui, il ne se passe rien : un numéro deviné ne peut pas atteindre un fait d’une autre conversation, même réel et sur le même serveur.
C’est pourquoi Nombre maximum de souvenirs injectés compte doublement. Un fait qui n’arrive jamais jusqu’au modèle ne peut jamais être réexaminé par lui : il reste jusqu’à ce que quelqu’un le supprime depuis cette page. Avec l’archive consultable, ce n’est plus une impasse : un fait que le bot va chercher est aussi un fait qu’il peut corriger.
🧭 Choisir un type de mémoire
Le Type de mémoire est un choix par serveur, fait sur cette page Mémoire - et non sur la page de réglages d’AI Response. Il décide de la façon dont le bot stocke ce qu’il sait et dont il le retrouve, et il est enregistré dès que tu cliques. Ce n’est pas une liste déroulante : clique dessus et les six types s’ouvrent sur la page, côte à côte, chacun avec ce qu’il fait, ce qu’il change, ce que le passage à ce type déplacerait, et où en lire davantage.
Le haut de la page représente les six types comme une seule échelle, avec la position de ton serveur marquée dessus, avant même que tu ouvres le sélecteur.
La page de réglages d’AI Response contient toujours les réglages qui accompagnent le type actif : les poids de classement (fraîcheur, importance, pertinence), le nombre de faits injectés, et les modèles utilisés pour la passe de consolidation en arrière-plan et pour les embeddings sémantiques. Cette page t’indique exactement où se trouve chacun d’eux, pour que tu n’aies jamais à les chercher.
Classic est ce qui tourne aujourd’hui, et c’est le choix par défaut. Un serveur qui n’ouvre jamais ce champ continue de se comporter exactement comme avant : une liste plate de faits, les plus récemment mis à jour injectés dans chaque réponse, rien de supprimé tout seul.
Les cinq autres ajoutent chacun une chose par rapport au précédent, et ils sont construits dans cet ordre :
- Journal : disponible maintenant. Un fait qui cesse d’être vrai est retiré plutôt qu’effacé, pour que tu puisses toujours lire ce qu’il disait. Voir la section suivante.
- Archive consultable : disponible maintenant. Le bot peut chercher quelque chose au lieu de n’utiliser que les faits qu’on lui a remis, de sorte que ce qui dépasse ta limite d’injection cesse d’être invisible. Voir la section d’après.
- Mémoire classée : disponible maintenant. Les places vont aux faits les plus utiles plutôt que simplement aux plus récents.
- Mémoire consolidée : disponible maintenant. Une passe en arrière-plan rassemble les doublons et réécrit le résumé pendant que le serveur est calme, et te propose chacune de ces modifications pour approbation.
- Mémoire sémantique : une correspondance sur le sens plutôt que sur les mots, de sorte que « il parle français » retrouve « la langue du serveur est le français ». Le plus puissant des six, et le seul qui s’accompagne d’une facture.
Le seul type qui n’est pas encore prêt est signalé dans la fenêtre et ne peut pas être sélectionné. Quel que soit le type, les deux mêmes règles s’appliquent : ils lisent tous la même mémoire, et aucun ne supprime quoi que ce soit tout seul. Changer d’avis, et revenir en arrière, ne te coûte donc jamais un fait.
Avec un serveur sélectionné, la page Mémoire t’indique ce qu’un changement déplacerait réellement, en nombres, avant que tu le fasses.
📓 Journal : rien n’est effacé, seulement retiré
Avec Journal, le bot ne supprime plus un fait qu’il juge périmé. La période de validité du fait prend simplement fin : il sort du contexte donné à l’IA, et il reste sur cette page avec la date à laquelle il s’est arrêté et, quand il y en a un, le fait qui l’a remplacé.
Le bot gagne aussi le geste qui va avec. Au lieu de pouvoir seulement abandonner [#12], il peut dire « celui-ci n’est plus vrai, voici ce qui le remplace », et on lui dit en toutes lettres que l’ancienne formulation est conservée. Une correction qu’on croit destructrice est une correction qu’on hésite à faire.
Lire l’historique
Trois onglets apparaissent au-dessus du tableau dès que quelque chose a été retiré :
- En vigueur : ce que le bot peut réellement voir. C’est l’onglet par défaut, et c’est la vraie réponse de la page à « que sait le bot ? ».
- Retirés : ce qui était vrai auparavant. Barré, avec la date, la raison si le bot en a donné une, et le remplaçant.
- Tout : les deux, dans une seule liste.
Annuler une mauvaise décision
Le bot se trompe parfois. Rétablir, sur une ligne retirée, la rouvre en un clic : c’est toute la raison pour laquelle la ligne a été conservée au lieu d’être supprimée. Le remplaçant, s’il y en avait un, est volontairement laissé tel quel : deux faits peuvent être vrais en même temps, et lequel des deux part, c’est à toi d’en décider, pas au panel.
Supprimer supprime toujours, sur une ligne retirée comme sur n’importe quelle autre. Une personne qui retire un fait depuis cette page a tranché ; rien ne remet cela en question.
Passer à Journal, puis revenir
Activer Journal ne déplace rien. Chaque fait que tu as déjà compte comme toujours vrai, ce qu’il était déjà, et garde sa date de création.
Revenir à Classic laisse tout ce qui a été retiré entre-temps exactement où c’est : toujours sur cette page, toujours invisible pour le bot. Si tu veux tout remettre devant l’IA, la page Mémoire propose Rétablir tous les faits retirés pour ce seul serveur, et l’inscrit dans ton journal d’audit. Ce n’est jamais fait à ta place : ce que le journal a retiré, il l’a retiré pour une raison.
🔎 Archive consultable : le bot peut chercher
La mémoire Classic a une vraie limite, et ce n’est pas le nombre de faits que tu peux stocker. C’est que tout ce qui dépasse Nombre maximum de souvenirs injectés est invisible pour l’IA, aussi vrai que cela soit. Augmenter la limite est le seul levier, et cela rend chaque message plus coûteux.
Archive consultable donne au bot l’autre levier. Les faits récents lui sont remis comme d’habitude, et en plus il peut en demander un par son nom : « cherche dans la mémoire : anniversaire de Paul ». Ce qu’il trouve lui est donné avant qu’il réponde.
Ce que ça coûte
Rien sur les messages où le bot ne cherche rien, c’est-à-dire la plupart. Quand il cherche quelque chose, cela coûte exactement un appel supplémentaire à l’IA : la question est reposée avec les faits en main. Jamais deux : un bot qui demande à chercher de nouveau dans sa deuxième réponse est ignoré.
La recherche elle-même est en texte intégral, exécutée par la base de données. Pas d’embeddings, pas de vecteurs, rien de calculé à chaque message, et aucun service tiers impliqué.
Ce qu’il peut atteindre
Tous les faits de ce serveur qui sont encore en vigueur, dans les deux portées : les faits sur le serveur et les faits sur ses membres. C’est voulu : « l’anniversaire de Paul » est un fait sur quelqu’un qui n’est pas la personne qui parle, et une recherche qui ne pourrait atteindre que les faits de celui qui parle passerait à côté de la plupart des questions qui valent la peine d’être posées.
Ce qu’il ne peut pas atteindre : tout ce qui est retiré dans un journal (clore la période d’un fait, c’est précisément décider de ne pas le redonner), et tout ce qui se trouve dans un salon où la lecture de la mémoire n’est pas autorisée. Une recherche est une lecture, et elle respecte le même réglage Salons où la mémoire peut être LUE.
Un fait que le bot a trouvé en cherchant est aussi un fait qu’il peut corriger, aux mêmes conditions que ceux qu’on lui a remis.
Avant de changer : la simulation
Avec un serveur sélectionné, la page Mémoire t’indique ce que l’archive te coûterait, avec des chiffres tirés de tes propres données : combien de faits il y a à indexer, quelle quantité de texte cela représente, et combien de temps une vraie recherche sur ces faits vient de prendre.
L’activer ne déplace rien et ne réécrit rien. L’index est construit sur le texte déjà stocké, et il existe pour chaque serveur, qu’il fasse des recherches ou non : changer, puis revenir en arrière, est donc instantané dans les deux cas.
🏅 Mémoire classée : les places vont aux faits qui les méritent
La mémoire Classic remet au modèle les N derniers faits modifiés. Autrement dit, une règle que ton serveur suit depuis un an perd sa place au profit de la discussion banale d’hier, parce que cette discussion a été touchée plus récemment.
Mémoire classée note chaque fait candidat sur trois critères et remet à la place les N meilleurs :
- Sa fraîcheur.
- Son importance : notée par le modèle au moment où il écrit le fait, qui est le seul moment où la raison de le stocker est encore devant lui.
- Son rapport avec ce qui se dit en ce moment.
C’est un classement, pas un filtre. Rien n’est écarté définitivement, et un fait qui rate la sélection sur un message redevient candidat au suivant.
Les poids sont à toi
Trois réglages de la page AI Response (fraîcheur, importance, pertinence) décident du poids de chaque critère, serveur par serveur. Un serveur dont la mémoire est surtout faite de règles permanentes voudra que l’importance pèse plus que la fraîcheur ; un serveur social très actif voudra l’inverse.
La confiance déjà stockée avec chaque fait est lue elle aussi. Elle agit comme un multiplicateur, et seulement à la baisse : un fait dont le bot n’était pas sûr ne passe pas devant un fait dont il était certain.
Changer ne coûte rien
Il n’y a ni migration ni facture. Un fait que personne n’a encore noté se classe au milieu plutôt qu’en dernier : le classement fonctionne donc dès le premier message sur ce que tu as déjà, et l’importance se remplit toute seule à mesure que le bot réécrit des faits.
La simulation indique combien de tes faits portent déjà une note, et montre lesquels gagneraient une place et lesquels en perdraient une.
🧩 Mémoire consolidée : le rangement se fait quand le serveur est calme
Une mémoire qui grossit finit par dire deux fois la même chose sous deux noms : language d’un côté, lang de l’autre. Jusqu’ici, la seule façon de s’en occuper était de le faire à la main.
Mémoire consolidée ajoute une passe en arrière-plan sur la mémoire d’un serveur devenu calme. Elle ne tourne jamais au milieu d’une réponse et, c’est l’essentiel, elle n’applique rien toute seule.
Elle propose, tu décides
La passe écrit des propositions. Elles apparaissent une à une sur la page Mémoire, le fait conservé à côté du fait qu’il remplacerait, et chacune a trois réponses :
- Fusionner : suivre la suggestion de la passe.
- Fusionner dans l’autre sens : garder l’autre fait à la place. Sur deux faits qui se contredisent, c’est toi qui sais lequel est encore vrai.
- Garder les deux : refuser. La passe ne redemandera pas, sauf si l’un des deux faits est réécrit ensuite.
Rien ne change tant que l’un de ces boutons n’a pas été cliqué.
Un oui n’efface jamais
Une fusion est un remplacement au sens du journal. Le fait qui s’efface clôt sa période en pointant vers celui qui reste, il apparaît barré sur cette page avec sa date et sa raison, et Rétablir le ramène. Une fusion s’annule exactement comme n’importe quel autre retrait.
Les contradictions ne sont jamais fusionnées. Deux faits qui disent des choses opposées sont signalés pour qu’une personne tranche. Rien dans la passe ne sait lequel est encore vrai.
Le résumé est réécrit
Le résumé est la seule ligne de mémoire que le bot lit en entier, à chaque fois : c’est donc aussi la première qui devient obsolète. Elle a été écrite une fois, à partir de ce qu’on savait alors.
La passe rédige ce qu’elle dirait aujourd’hui à partir des faits valables pour tout le serveur, et la page met les deux côte à côte : ce que ton bot lit aujourd’hui, et ce qu’il lirait à la place. Même règle qu’une fusion : rien ne le remplace sans un oui, et l’ancienne formulation est retirée plutôt que supprimée.
Son propre modèle
Cette passe n’est pas en course contre une réponse Discord : elle peut donc tourner sur un modèle plus puissant, ou moins cher, différent de celui qui répond dans le salon, avec son propre point d’accès et sa propre clé, comme chaque champ de modèle dans le panel.
Elle fonctionne aussi sans aucun modèle. Sans modèle, la passe trouve et propose quand même chaque paire ; une fusion se contente de garder le fait gagnant mot pour mot, au lieu de réécrire les deux en une seule phrase. Le modèle n’écrit jamais que la formulation suggérée et le brouillon du résumé.
Quand elle tourne
À son propre rythme, et elle se refuse elle-même chaque fois qu’une passe ne serait pas rentable : une mémoire trop petite pour contenir des doublons, rien de changé depuis la dernière passe, moins d’un jour depuis la précédente, ou une proposition qui attend déjà une réponse. Un serveur qui n’est jamais calme a quand même sa passe au bout d’une semaine, car c’est justement le serveur dont la mémoire se remplit de doublons.
Avant de changer : la simulation
La carte t’indique, sur tes propres données, combien de faits sont stockés, combien de doublons et combien de contradictions une passe trouverait, avec cinq exemples réels tirés de ton serveur.
L’activer ne déplace rien. La première passe propose ; tu décides.
🧠 Mémoire sémantique : le sens plutôt que les mots
Chaque type précédent répond au fond à la même question : ces deux textes ont-ils des mots en commun ? Pour « il parle français » et « la langue du serveur est le français », la réponse est non : un seul mot en commun, et ce n’est pas le plus utile.
Mémoire sémantique transforme chaque fait en embedding : une direction plutôt qu’une chaîne de caractères. Deux faits qui veulent dire la même chose pointent dans la même direction, quels que soient les mots avec lesquels ils ont été écrits, et la proximité entre eux est un nombre que le panel peut comparer.
Ce qui change vraiment
Deux choses, et la seconde est celle que tu ressens tous les jours.
La recherche cesse de rater des choses. Quand le bot va chercher un fait qu’on ne lui a pas remis, il ne dépend plus du fait que le membre ait employé le même mot que la personne qui a noté le fait.
Le classement cesse de dépendre des mots du message. Avec Mémoire classée, un fait obtient sa pertinence d’après sa position dans les résultats de recherche. Avec Sémantique, il est noté sur sa proximité réelle avec ce qui se dit : la différence entre « ce fait a été trouvé » et « ce fait parle de ceci ».
Ce que ça coûte
C’est le seul type qui envoie tes données quelque part de façon planifiée, donc le coût mérite d’être énoncé clairement :
- Un appel d’embedding par fait écrit, une seule fois. Un fait qui n’est pas reformulé n’est jamais intégré deux fois.
- Un appel par message assez long pour être classé. En dessous de douze caractères, rien n’est envoyé : « lol » n’a rien à rapprocher.
- La comparaison elle-même se fait dans le panel, pas dans la base de données, ce qui explique que ce type soit à l’aise jusqu’à quelques milliers de faits par serveur, et pas beaucoup plus loin.
Il faut un modèle d’embedding, nommé sur le même point d’accès et avec la même clé que le reste de tes réglages d’IA.
Il se rabat tout seul sur autre chose
Aucun modèle nommé, un point d’accès qui refuse, une passe de rattrapage qui n’a pas encore tourné, ou un modèle d’embedding que tu viens de changer : dans tous ces cas, la recherche revient à la correspondance par mots au lieu d’échouer. La réponse indique lequel des deux a réellement tourné, pour qu’un repli silencieux reste visible.
Changer de modèle d’embedding refait l’embedding de tout, et tant que cette passe n’est pas terminée, le serveur cherche par mots. Rien ne casse entre-temps.
Avant de changer : la simulation
La carte t’indique combien d’appels la passe de rattrapage ferait, sur quelle quantité de texte, et lesquels de tes faits les vecteurs considèrent déjà comme la même chose.
Aucun prix en monnaie. Y mettre un montant reviendrait à inventer un tarif pour l’point d’accès que tu as nommé, et un chiffre inventé sur une page qui parle d’argent est pire que pas de chiffre du tout.
🧹 Effacer la mémoire
Supprimer les entrées une par une convient pour un seul fait erroné. Pour deux autres cas, il y a Effacer la mémoire, à côté du filtre de serveur une fois que tu en as choisi un :
- Tout ce qui concerne ce serveur : quand la mémoire a assez dérivé pour que repartir de zéro vaille mieux que vingt corrections.
- Tout ce qui concerne un membre : quand quelqu’un est parti, ou demande à être oublié. Saisis son identifiant d’utilisateur Discord.
C’est immédiat et irréversible, et le bot recommence à apprendre dès la conversation suivante. Chaque effacement est inscrit dans ton journal d’audit au nom de la personne qui l’a fait, avec le nombre d’entrées parties.
🔑 Contrôle d’accès
Les entrées de mémoire sont visibles pour toute personne ayant accès à l’équipe propriétaire du serveur.
Les modifier est un autre droit : ajouter, modifier, supprimer et effacer demandent tous la permission de configurer le serveur, la même que celle dont les réglages des fonctionnalités ont besoin. Sans elle, tu peux toujours lire la liste, et le bouton Effacer la mémoire n’est simplement pas là.
Ne stocke pas de secrets sensibles, de mots de passe, de tokens privés ni d’informations confidentielles dans la mémoire IA.
🧵 Fils
La lecture et l’écriture de la mémoire suivent les réglages Salons où la mémoire peut être LUE et Salons où la mémoire peut être ÉCRITE, et un fil n’est pas l’un de ces salons, même si le salon dans lequel il a été ouvert l’est. Par défaut, la mémoire n’est ni lue ni écrite dans les fils. L’option Inclure les fils d’AI Response (désactivée par défaut) permet à un fil de suivre le salon dans lequel il a été créé ; voir AI Response. Garde-la désactivée si un fil peut être ouvert à des personnes qui ne devraient pas voir ce que contient la mémoire.
✨ Mémoire et qualité des réponses
Plus de mémoire n’est pas toujours mieux.
Trop de faits sans rapport peuvent rendre l’IA moins concentrée.
Une bonne mémoire doit être :
- Courte
- Exacte
- Pertinente
- À jour
- Facile à comprendre
💡 Bonnes pratiques
- Passe la mémoire en revue après les grands changements sur le serveur.
- Supprime les faits périmés.
- Efface les entrées d’un membre quand il demande à être oublié, plutôt que de chercher ses lignes une à une.
- Garde les règles importantes claires et explicites.
- Ne stocke pas de données privées d’utilisateurs sauf si tu as une bonne raison et une autorisation.
- Utilise la mémoire pour améliorer le contexte, pas pour remplacer la modération ou le jugement de l’équipe.