A Memória de IA permite que o YAWBDB guarde contexto útil de um servidor para que as respostas da IA fiquem mais consistentes com o tempo.
Duas fontes escrevem nela: você, pelo painel, e o bot, que anota o que aprende nas conversas no Discord. O sistema de memória é gerenciado pelo painel, e nada nele é removido automaticamente.
🧠 Para que serve a memória
A memória pode ajudar a IA a lembrar de informações como:
- O universo do servidor
- Fatos da comunidade
- O tom preferido
- Piadas recorrentes
- Contexto de usuários ou cargos
- Terminologia própria do servidor
- Regras ou lembretes importantes
O objetivo é fazer as respostas da IA parecerem mais conscientes do servidor.
📒 Página de memória
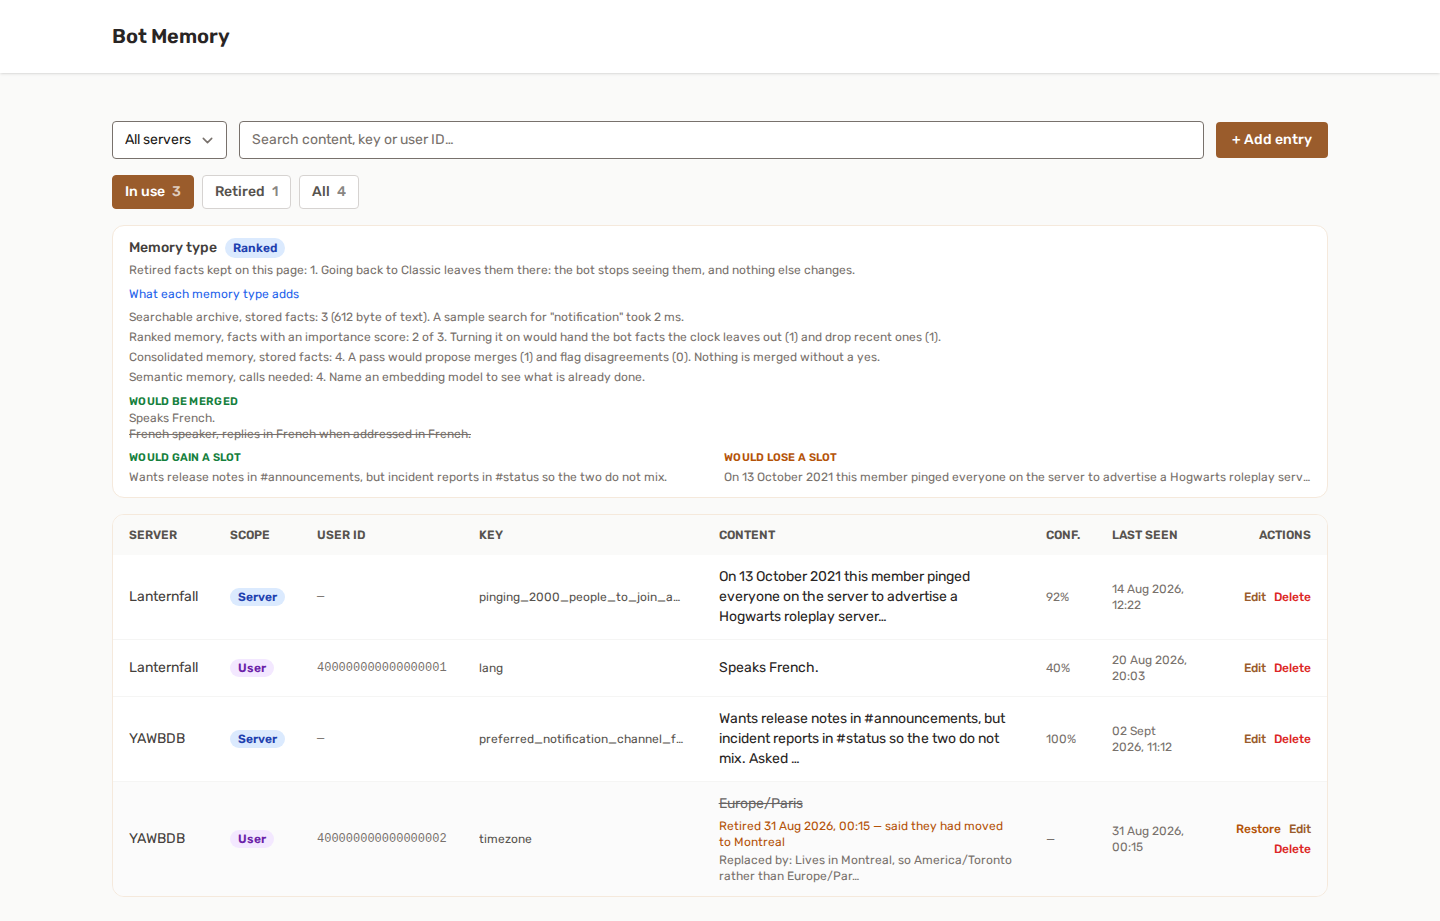
A página de Memória dá aos usuários autorizados uma visão completa das entradas armazenadas.
Nessa página, você pode:
- Ver as memórias por servidor
- Pesquisar por chave ou conteúdo
- Adicionar novas memórias manualmente
- Editar memórias existentes
- Excluir memórias desatualizadas
- Revisar os valores de confiança
🔎 Filtros e paginação
A memória pode ser filtrada por servidor e pesquisada instantaneamente.
Conjuntos grandes de memória são paginados para que a página continue utilizável.
✍️ Entradas de memória manuais
Você pode adicionar entradas de memória manualmente quando quiser que a IA saiba algo específico.
Exemplos:
server_theme: Este servidor é sobre jogos retrô.bot_tone: As respostas devem ser amigáveis e concisas.important_rule: Não dê suporte em canais públicos; direcione os usuários para os tickets.
Use entradas curtas e claras. Evite despejar parágrafos enormes, a menos que seja necessário.
✏️ Editando a memória
Você pode editar:
- Chave
- Conteúdo
- Confiança
Edite uma memória quando ela ainda for útil, mas precisar de correção.
Exclua-a quando estiver desatualizada ou já não for relevante.
♻️ Nada é esquecido pelas suas costas
As entradas nunca são removidas automaticamente. Não há expiração nem rotina de limpeza: um fato permanece até que o próprio bot decida que ele não vale mais, ou até que alguém o remova desta página.
O que você controla é quanto dessa memória chega à IA. Máximo de lembranças injetadas, na página de configurações de Respostas de IA, define quantos fatos são enviados como contexto, de 1 a 1000, com 20 por padrão. Aumentar o valor dá mais material à IA; diminuir deixa as respostas mais enxutas. Nada é excluído em nenhum dos casos, então você pode subir e descer o valor à vontade.
A idade não é motivo para esquecer. Este servidor fala francês continua verdadeiro dois anos depois, e nada vai afirmá-lo de novo.
Como o bot decide
Cada fato enviado ao modelo traz o seu próprio número, mostrado como [#12] no contexto que o modelo recebe. Quando o bot conclui que algo deixou de valer, como uma regra que mudou ou uma preferência que alguém reverteu, ele responde com esse número, e a entrada deixa de ser usada. Se ela é excluída ou mantida para consulta, depende do tipo de memória, descrito abaixo.
Ele só pode remover um fato que realmente lhe foi mostrado naquela troca. Se ele citar um número que não estava diante dele, nada acontece: um número adivinhado não alcança um fato de outra conversa, mesmo que seja real e do mesmo servidor.
É por isso que Máximo de lembranças injetadas importa em dobro. Um fato que nunca chega ao modelo nunca pode ser reexaminado por ele, e fica até que alguém o remova desta página. Com o Arquivo pesquisável, isso deixa de ser um beco sem saída: um fato que o bot consulta é um fato que ele também pode corrigir.
🧭 Escolhendo um tipo de memória
O Tipo de memória é uma escolha por servidor, feita nesta página de Memória, e não na página de configurações de Respostas de IA. Ele decide como o bot guarda o que sabe e como o recupera, e é salvo no momento em que você clica. Não é um menu suspenso: ao clicar, os seis tipos se abrem sobre a página, lado a lado, cada um com o que faz, o que muda, o que a troca para ele moveria e onde saber mais.
O topo da página desenha os seis tipos como uma única escala, com a posição do seu servidor marcada, antes mesmo de você abrir o seletor.
A página de configurações de Respostas de IA continua guardando as configurações que acompanham o tipo ativo: os pesos de classificação (recência, importância, relevância), quantos fatos são injetados e os modelos usados na consolidação em segundo plano e nos embeddings semânticos. Esta página diz exatamente onde cada uma delas fica, para você nunca precisar sair procurando.
O Classic é o que roda hoje e é o padrão. Um servidor que nunca abre esse campo continua se comportando exatamente como sempre: uma lista simples de fatos, os atualizados mais recentemente injetados em cada resposta, nada removido por conta própria.
Os outros cinco acrescentam, cada um, uma coisa sobre o anterior, e estão sendo construídos em ordem:
- Journal - disponível agora. Um fato que deixa de ser verdadeiro é retirado em vez de apagado, para que você ainda possa ler o que ele dizia. Veja a próxima seção.
- Arquivo pesquisável - disponível agora. O bot pode consultar algo em vez de usar só os fatos que recebeu, então o que fica além do seu limite de injeção deixa de ser invisível. Veja a seção depois da próxima.
- Memória classificada - disponível agora. As vagas vão para os fatos mais úteis, e não apenas para os mais recentes.
- Memória consolidada - disponível agora. Uma passagem em segundo plano reúne duplicatas e reescreve o resumo enquanto o servidor está quieto, e propõe cada uma dessas mudanças para você aprovar.
- Memória semântica - busca por significado em vez de por palavras, de modo que "ele fala francês" encontra "o idioma do servidor é o francês". A mais forte das seis, e a única com uma conta associada.
O único tipo que ainda não está pronto aparece marcado na janela e não pode ser selecionado. Seja qual for o tipo, valem as mesmas duas regras: todos leem a mesma memória, e nenhum deles exclui nada por conta própria, então mudar de ideia e voltar atrás nunca custa um fato.
Com um servidor escolhido, a página de memória diz o que uma mudança moveria de fato, em números, antes de você fazê-la.
📓 Journal - nada é apagado, só retirado
No Journal, o bot deixa de excluir um fato que ele decide estar desatualizado. O período de validade do fato simplesmente termina: ele sai do contexto dado à IA e permanece nesta página com a data em que parou e, quando houver, o fato que o substituiu.
Ele também ganha o gesto correspondente. Em vez de só poder descartar [#12], o bot pode dizer "este aqui não é mais verdadeiro, e este o substitui", e é informado, com todas as letras, de que a redação antiga sobrevive. Uma correção que ele considera destrutiva é uma correção que ele hesita em fazer.
Lendo o histórico
Três abas aparecem acima da tabela assim que algo é retirado:
- Em vigor - o que o bot realmente consegue ver. É o padrão, e a verdadeira resposta da página para "o que o bot sabe?".
- Retirados - o que costumava ser verdade. Riscados, com a data, o motivo se o bot o deu e a substituição.
- Tudo - os dois, em uma única lista.
Desfazendo um erro
O bot às vezes erra. Restaurar, em uma linha retirada, a reabre com um clique: é esse o motivo de a linha ter sido mantida em vez de excluída. A substituição, se houve, é deixada de propósito como está: dois fatos podem ser verdadeiros ao mesmo tempo, e qual dos dois sai é decisão sua, não do painel.
Excluir continua excluindo, em uma linha retirada como em qualquer outra. Quem remove um fato desta página já decidiu; nada questiona isso.
Trocando e voltando
Ativar o Journal não move nada. Todo fato que você já tem conta como ainda verdadeiro, que é o que ele já era, e mantém a data em que foi criado.
Voltar ao Classic deixa o que foi retirado nesse meio-tempo exatamente onde está: ainda nesta página, ainda sem ser visto pelo bot. Se você quiser tudo de volta diante da IA, a página de memória oferece Restaurar todos os factos retirados para aquele servidor, e registra a ação no seu registro de auditoria. Isso nunca é feito por você: o que o journal retirou, ele retirou por um motivo.
🔎 Arquivo pesquisável - o bot pode consultar
A memória Classic tem um limite real, e não é o número de fatos que você pode guardar. É que tudo o que passa de Máximo de lembranças injetadas fica invisível para a IA, por mais verdadeiro que seja. Aumentar o limite é a única alavanca, e isso encarece cada mensagem.
O Arquivo pesquisável dá ao bot a outra alavanca. Os fatos recentes são entregues a ele como de costume e, além disso, ele pode pedir um pelo nome: "pesquise na memória: aniversário do Paulo". O que ele encontra lhe é entregue antes de responder.
Quanto custa
Nada nas mensagens em que o bot não consulta nada, que são a maioria. Quando ele consulta, custa exatamente uma chamada extra à IA: a pergunta é feita de novo com os fatos em mãos. Nunca duas: se o bot pedir para pesquisar de novo na segunda resposta, o pedido é ignorado.
A busca em si é texto completo, executada pelo banco de dados. Sem embeddings, sem vetores, nada calculado por mensagem e nenhum serviço de terceiros envolvido.
O que ele alcança
Todo fato daquele servidor que ainda está em uso, nos dois escopos: fatos sobre o servidor e fatos sobre os membros. Isso é proposital: "aniversário do Paulo" é um fato sobre alguém que não é quem está falando, e uma busca que só alcançasse os fatos de quem fala perderia a maioria das perguntas que valem a pena.
O que ele não alcança: qualquer coisa retirada em um journal, pois fechar a janela de um fato é justamente a decisão de não devolvê-lo, e qualquer coisa em um canal onde a leitura de memória não é permitida. Uma busca é uma leitura e obedece à mesma configuração de Canais onde a memória pode ser LIDA.
Um fato que o bot encontrou pesquisando é também um fato que ele pode corrigir, nas mesmas condições dos que lhe foram entregues.
Antes de ativar: o teste a seco
Com um servidor escolhido, a página de memória diz quanto o arquivo custaria, com números tirados dos seus próprios dados: quantos fatos há para indexar, quanto texto isso representa e quanto tempo uma busca real sobre eles acabou de levar.
Ativá-lo não move nem reescreve nada. O índice é construído sobre o texto que já está armazenado e existe para todos os servidores, pesquisem eles ou não, então trocar e voltar é instantâneo nos dois sentidos.
🏅 Memória classificada - as vagas vão para os fatos que as merecem
A memória Classic entrega ao modelo os últimos N fatos modificados. Dito de outro modo: uma regra pela qual o seu servidor vive há um ano perde o lugar para a conversa fiada de ontem, porque a conversa fiada foi mexida mais recentemente.
A Memória classificada dá nota a cada fato candidato em três critérios e entrega os N melhores:
- Quão recente ele é.
- Quão importante ele é, avaliado pelo modelo no momento em que grava o fato, o único momento em que o motivo de guardá-lo ainda está diante dele.
- Quanto tem a ver com o que está sendo dito agora.
É um ranking, não um filtro. Nada é deixado de lado para sempre, e um fato que fica de fora numa mensagem volta a ser candidato na seguinte.
Os pesos são seus
Três configurações na página de Respostas de IA (recência, importância, relevância) decidem quanto cada critério conta, por servidor. Um servidor cuja memória é feita sobretudo de regras permanentes vai querer que a importância pese mais que a novidade; um servidor social movimentado vai querer o contrário.
A confiança já armazenada com cada fato também é lida. Ela age como um multiplicador, e só para baixo: um fato sobre o qual o bot estava inseguro não passa na frente de um que ele tinha certeza.
Trocar não custa nada
Não há migração nem cobrança. Um fato que ninguém pontuou ainda fica no meio da classificação, e não no fim, então o ranking funciona desde a primeira mensagem sobre o que você já tem, e a importância se preenche sozinha conforme o bot reescreve os fatos.
O teste a seco diz quantos dos seus fatos já têm uma nota e mostra quais ganhariam uma vaga e quais a perderiam.
🧩 Memória consolidada - a arrumação acontece enquanto o servidor está quieto
Uma memória que cresce acaba dizendo a mesma coisa duas vezes com dois nomes: language de um lado, lang do outro. Até agora, a única forma de lidar com isso era à mão.
A Memória consolidada acrescenta uma passagem em segundo plano sobre a memória de um servidor que ficou quieto. Ela nunca roda no meio de uma resposta e, e este é o ponto importante, não aplica nada por conta própria.
Ela propõe, você decide
A passagem escreve propostas. Elas aparecem na página de memória uma a uma, com o fato mantido ao lado do fato que ele substituiria, e cada uma tem três respostas:
- Fundir - aceitar a sugestão da passagem.
- Fundir ao contrário - manter o outro fato. Entre dois fatos que discordam, quem sabe qual ainda é verdadeiro é você.
- Manter ambos - recusar. A passagem não perguntará de novo, a menos que um dos dois fatos seja reescrito depois.
Nada muda até que uma dessas opções seja clicada.
Um sim nunca apaga
Uma fusão é uma substituição no sentido do journal. O fato que sai de cena fecha a sua janela apontando para o que ficou, aparece riscado nesta página com a data e o motivo, e Restaurar o traz de volta. Uma fusão se desfaz exatamente como qualquer outra retirada.
Contradições nunca são fundidas. Dois fatos que dizem coisas opostas são sinalizados para uma pessoa resolver. Nada na passagem sabe qual deles ainda é verdadeiro.
O resumo é reescrito
O resumo é a única linha de memória que o bot lê inteira, toda vez, e por isso também é a primeira a ficar desatualizada. Ele foi escrito uma vez, a partir do que se sabia então.
A passagem redige o que diria hoje a partir dos fatos de todo o servidor, e a página coloca os dois lado a lado: o que o seu bot lê hoje e o que ele leria no lugar. Mesma regra de uma fusão: nada o substitui sem um sim, e a redação anterior é retirada em vez de excluída.
Seu próprio modelo
Essa passagem não está correndo contra uma resposta do Discord, então pode rodar em um modelo mais forte, ou mais barato, diferente do que responde no canal, com o seu próprio endpoint e a sua própria chave, como todo campo de modelo no painel.
Ela também funciona sem nenhum modelo. Sem um, a passagem ainda encontra e propõe todos os pares; a fusão apenas mantém o fato vencedor palavra por palavra, em vez de reescrever os dois em uma só frase. O modelo só escreve a redação sugerida e o rascunho do resumo.
Quando ela roda
No seu próprio ritmo, e ela se recusa a rodar sempre que uma passagem não valeria a pena: memória pequena demais para ter duplicatas, nada mudou desde a última passagem, menos de um dia desde a última, ou uma proposta ainda esperando resposta. Um servidor que nunca fica quieto recebe a passagem mesmo assim depois de uma semana, porque é exatamente o servidor cuja memória se enche de duplicatas.
Antes de ativar: o teste a seco
O cartão diz, com os seus dados, quantos fatos estão armazenados, quantas duplicatas e quantas contradições uma passagem encontraria, com cinco exemplos reais tirados do seu servidor.
Ativá-la não move nada. A primeira passagem propõe; você decide.
🧠 Memória semântica - significado em vez de palavras
Todo tipo anterior responde, no fundo, à mesma pergunta: esses dois textos têm palavras em comum? Para "ele fala francês" e "o idioma do servidor é o francês", a resposta é não: uma palavra em comum, e não é a útil.
A Memória semântica transforma cada fato em um embedding: uma direção em vez de uma sequência de caracteres. Dois fatos que significam a mesma coisa apontam para o mesmo lado, com quaisquer palavras que tenham sido escritos, e a proximidade entre eles é um número que o painel consegue comparar.
O que muda de fato
Duas coisas, e a segunda é a que você sente todo dia.
A busca deixa de perder coisas. Quando o bot procura um fato que não lhe foi entregue, ele deixa de depender de o membro ter usado a mesma palavra de quem anotou o fato.
O ranking deixa de depender das palavras da mensagem. Na Classificada, um fato pontua em relevância pela posição em que apareceu nos resultados da busca. Na Semântica, pontua pela proximidade real com o que está sendo dito: a diferença entre "este fato foi encontrado" e "este fato é sobre isto".
Quanto custa
Este é o único tipo que envia os seus dados a algum lugar de forma programada, então vale dizer o custo com clareza:
- Uma chamada de embedding por fato gravado, uma única vez. Um fato que não é reescrito nunca é processado duas vezes.
- Uma chamada por mensagem longa o bastante para ser comparada. Com menos de doze caracteres, nada é enviado: "kkk" não tem nada para comparar.
- A comparação em si acontece no painel, não no banco de dados, e é por isso que o tipo funciona bem até alguns milhares de fatos por servidor e não muito além.
Ele precisa de um modelo de embedding, indicado no mesmo endpoint e na mesma chave do restante das suas configurações de IA.
Ele volta ao modo anterior sozinho
Nenhum modelo indicado, um endpoint que recusa, uma passagem de atualização que ainda não rodou ou um modelo de embedding que você acabou de trocar: em todos esses casos a busca volta a comparar palavras em vez de falhar. A resposta diz qual das duas rodou de fato, então um retorno silencioso continua visível.
Trocar o seu modelo de embedding reprocessa tudo, e até essa passagem terminar o servidor pesquisa por palavras. Nada quebra nesse meio-tempo.
Antes de ativar: o teste a seco
O cartão diz quantas chamadas a passagem de atualização faria, sobre quanto texto, e quais dos seus fatos os vetores já consideram a mesma coisa.
Nenhum preço em moeda. Colocar um valor ali seria inventar uma tarifa para o endpoint que você indicou, e um número inventado numa página sobre dinheiro é pior do que nenhum número.
🧹 Limpando a memória
Excluir entradas uma a uma é o certo para um único fato errado. Para outros dois casos existe Limpar a memória, ao lado do filtro de servidor depois que você escolhe um servidor:
- Tudo sobre este servidor - quando a memória se desviou tanto que recomeçar vale mais do que vinte correções.
- Tudo sobre um membro - quando alguém saiu ou pede para ser esquecido. Informe o id de usuário do Discord da pessoa.
É imediato e não pode ser desfeito, e o bot volta a aprender a partir da próxima conversa. Cada limpeza é registrada no seu registro de auditoria em nome de quem a fez, com o número de entradas removidas.
🔑 Controle de acesso
As entradas de memória são visíveis para qualquer pessoa com acesso à equipe dona do servidor.
Alterá-las é outro direito: adicionar, editar, excluir e limpar exigem permissão para configurar o servidor, a mesma que as configurações dos recursos exigem. Sem ela, a lista continua disponível para leitura, e o botão Limpar a memória simplesmente não aparece.
Não guarde segredos sensíveis, senhas, tokens privados ou informações confidenciais na memória de IA.
🧵 Tópicos
A leitura e a escrita da memória seguem as configurações Canais onde a memória pode ser LIDA e Canais onde a memória pode ser ESCRITA, e um tópico não é um desses canais, mesmo quando o canal em que ele foi aberto é. Por padrão, a memória não é lida nem escrita em tópicos. A opção Incluir tópicos da Resposta de IA (desativada por padrão) faz um tópico seguir o canal em que foi iniciado; veja Respostas de IA. Mantenha-a desativada se um tópico puder estar aberto a pessoas que não devem ver o que a memória guarda.
✨ Memória e qualidade das respostas
Mais memória nem sempre é melhor.
Fatos irrelevantes demais podem deixar a IA menos focada.
Uma boa memória deve ser:
- Curta
- Precisa
- Relevante
- Atualizada
- Fácil de entender
💡 Boas práticas
- Revise a memória depois de grandes mudanças no servidor.
- Exclua fatos desatualizados.
- Limpe as entradas de um membro quando ele pedir para ser esquecido, em vez de caçar as linhas dele.
- Mantenha as regras importantes claras e explícitas.
- Não guarde dados privados de usuários, a menos que haja um bom motivo e permissão.
- Use a memória para melhorar o contexto, não para substituir a moderação ou o julgamento da equipe.