Pamięć AI pozwala YAWBDB przechowywać przydatny kontekst serwera, dzięki czemu odpowiedzi AI z czasem stają się bardziej spójne.
Zapisują do niej dwie strony: Ty, z poziomu panelu, oraz bot, który notuje to, czego dowiaduje się z rozmów na Discordzie. Systemem pamięci zarządza się z panelu, a nic w nim nie jest nigdy usuwane automatycznie.
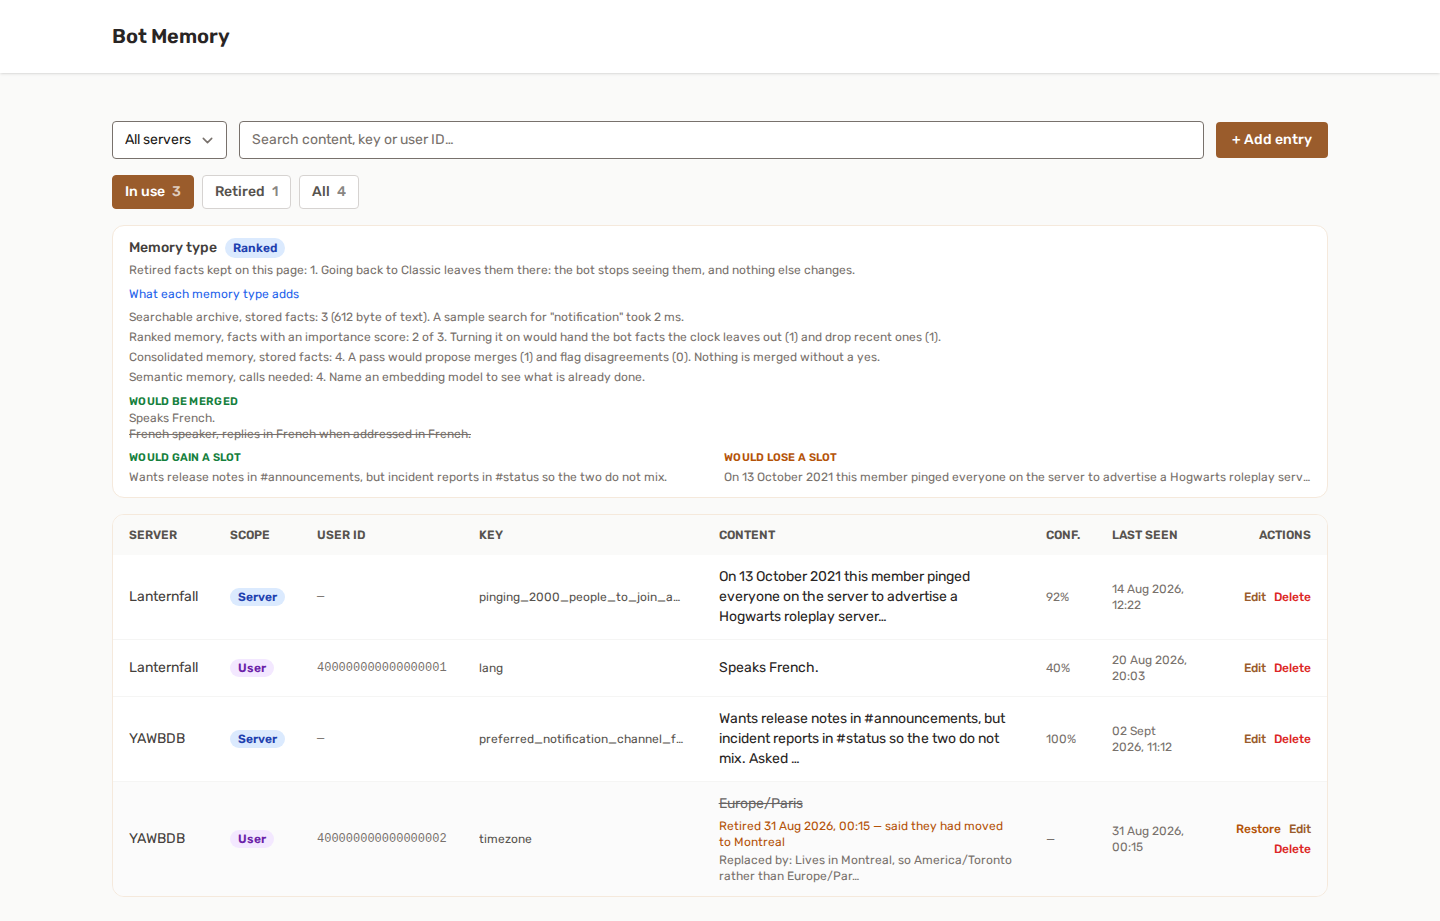
🧠 Do czego służy pamięć
Pamięć może pomóc AI zapamiętać takie informacje jak:
- Uniwersum serwera
- Fakty o społeczności
- Preferowany ton
- Powtarzające się żarty
- Kontekst dotyczący użytkowników lub ról
- Terminologia specyficzna dla serwera
- Ważne zasady lub przypomnienia
Celem jest, aby odpowiedzi AI sprawiały wrażenie bardziej świadomych tego, co dzieje się na serwerze.
📒 Strona Pamięć
Strona Pamięć daje uprawnionym osobom pełny wgląd w zapisane wpisy pamięci.
Na tej stronie możesz:
- Przeglądać wspomnienia według serwera
- Szukać po kluczu lub treści
- Dodawać nowe wspomnienia ręcznie
- Edytować istniejące wspomnienia
- Usuwać nieaktualne wspomnienia
- Sprawdzać wartości pewności
🔎 Filtrowanie i podział na strony
Pamięć można filtrować według serwera i przeszukiwać natychmiast.
Duże zbiory wspomnień są dzielone na strony, aby strona pozostała wygodna w użyciu.
✍️ Ręczne wpisy pamięci
Możesz dodawać wpisy pamięci ręcznie, gdy chcesz, aby AI wiedziało coś konkretnego.
Przykłady:
server_theme: Ten serwer jest o retro grach.bot_tone: Odpowiedzi powinny być przyjazne i zwięzłe.important_rule: Nie udzielaj wsparcia na kanałach publicznych; kieruj użytkowników do ticketów.
Używaj krótkich, jasnych wpisów. Unikaj wrzucania ogromnych akapitów, chyba że to konieczne.
✏️ Edytowanie pamięci
Możesz edytować:
- Klucz
- Treść
- Pewność
Edytuj wspomnienie, gdy nadal jest przydatne, ale wymaga poprawki.
Usuń je, gdy jest nieaktualne lub przestało być istotne.
♻️ Nic nie jest zapominane za Twoimi plecami
Wpisy nigdy nie są usuwane automatycznie. Nie ma wygasania ani zadania porządkującego: fakt zostaje, dopóki bot sam nie uzna, że przestał być prawdziwy, albo dopóki ktoś nie usunie go z tej strony.
Kontrolujesz to, ile z tego trafia do AI. Ustawienie Maksymalna liczba wstrzykiwanych wspomnień na stronie ustawień Odpowiedzi AI określa, ile faktów jest wysyłanych jako kontekst - od 1 do 1000, domyślnie 20. Podniesienie go daje AI więcej materiału; obniżenie sprawia, że odpowiedzi są bardziej zwarte. W obu przypadkach nic nie jest usuwane, więc możesz swobodnie zmieniać wartość w górę i w dół.
Wiek nie jest powodem, by zapomnieć. Ten serwer mówi po francusku jest prawdą także po dwóch latach i nikt tego nie powtórzy.
Jak bot podejmuje decyzję
Każdy fakt wysyłany do modelu ma własny numer, widoczny jako [#12] w kontekście, który model dostaje. Gdy bot uzna, że coś przestało być prawdą - zmieniona zasada, odwrócona preferencja - odpowiada tym numerem, a wpis przestaje być używany. To, czy zostanie usunięty, czy zachowany do wglądu, zależy od typu pamięci, opisanego niżej.
Może usunąć tylko fakt, który faktycznie został mu pokazany w danej wymianie. Jeśli poda numer, którego przed sobą nie miał, nic się nie dzieje: zgadnięty numer nie dosięgnie faktu z innej rozmowy, nawet prawdziwego, z tego samego serwera.
Dlatego Maksymalna liczba wstrzykiwanych wspomnień ma podwójne znaczenie. Fakt, który nigdy nie trafia do modelu, nigdy nie może zostać przez niego ponownie oceniony - zostaje, dopóki ktoś nie usunie go z tej strony. W przeszukiwalnym archiwum przestaje to być ślepy zaułek: fakt, który bot wyszuka, jest też faktem, który może poprawić.
🧭 Wybór typu pamięci
Typ pamięci to jeden wybór na serwer, dokonywany na tej stronie Pamięć - nie na stronie ustawień Odpowiedzi AI. Decyduje o tym, jak bot przechowuje to, co wie, i jak do tego wraca; jest zapisywany w chwili kliknięcia. To nie jest lista rozwijana: po kliknięciu sześć typów otwiera się na stronie obok siebie, każdy z opisem tego, co robi, co zmienia, co przeniosłoby przejście na niego i gdzie przeczytać więcej.
Na górze strony sześć typów jest narysowanych jako jedna skala, z zaznaczoną pozycją Twojego serwera, jeszcze zanim otworzysz wybór.
Strona ustawień Odpowiedzi AI nadal zawiera ustawienia, które idą w parze z aktywnym typem - wagi rankingu (świeżość, ważność, trafność), liczbę wstrzykiwanych faktów oraz modele używane do konsolidacji w tle i do embeddingów semantycznych. Ta strona mówi dokładnie, gdzie każde z nich się znajduje, więc nie musisz niczego szukać.
Classic to to, co działa dziś, i jest domyślne. Serwer, który nigdy nie otworzy tego pola, zachowuje się dokładnie tak jak zawsze: płaska lista faktów, do każdej odpowiedzi trafiają te ostatnio zmienione, nic nie jest usuwane samo.
Pozostałe pięć dodaje po jednej rzeczy do poprzedniego i są budowane po kolei:
- Journal - dostępny teraz. Fakt, który przestaje być prawdziwy, jest wycofywany zamiast wymazywany, więc nadal możesz przeczytać, co mówił. Zobacz następną sekcję.
- Przeszukiwalne archiwum - dostępne teraz. Bot może coś wyszukać, zamiast używać tylko faktów, które mu podano, więc to, co leży poza Twoim limitem wstrzykiwania, przestaje być niewidoczne. Zobacz sekcję po następnej.
- Pamięć rankingowa - dostępna teraz. Miejsca zajmują najbardziej przydatne fakty, a nie tylko najnowsze.
- Pamięć skonsolidowana - dostępna teraz. Przebieg w tle łączy duplikaty i przepisuje podsumowanie, gdy serwer jest spokojny, a każdą zmianę proponuje Tobie do zatwierdzenia.
- Pamięć semantyczna - dopasowywanie według znaczenia, a nie słów, więc „mówi po francusku” znajdzie „językiem serwera jest francuski”. Najmocniejszy z sześciu i jedyny, za który trzeba płacić.
Jedyny typ, który nie jest jeszcze gotowy, jest oznaczony w oknie i nie można go wybrać. Niezależnie od typu obowiązują te same dwie zasady: wszystkie czytają tę samą pamięć i żaden nie usuwa niczego sam z siebie - więc zmiana zdania i powrót nigdy nie kosztują Cię żadnego faktu.
Gdy wybrany jest jeden serwer, strona Pamięć mówi Ci, co faktycznie przeniosłaby zmiana, w liczbach, zanim ją wprowadzisz.
📓 Journal - nic nie jest wymazywane, tylko wycofywane
W typie Journal bot nie usuwa już faktu, który uzna za nieaktualny. Okres obowiązywania faktu po prostu się kończy: fakt znika z kontekstu przekazywanego AI i zostaje na tej stronie z datą zakończenia oraz, jeśli istnieje, z faktem, który go zastąpił.
Bot zyskuje też pasujący do tego ruch. Zamiast móc tylko porzucić [#12], może powiedzieć „to już nie jest prawda, oto, co to zastępuje” - i dostaje wyraźną informację, że stare brzmienie przetrwa. Poprawka, którą uważa za destrukcyjną, to poprawka, której się obawia.
Czytanie historii
Gdy cokolwiek zostanie wycofane, nad tabelą pojawiają się trzy karty:
- Obowiązujące - to, co bot faktycznie widzi. To ustawienie domyślne i rzeczywista odpowiedź strony na pytanie „co wie bot?”.
- Wycofane - to, co kiedyś było prawdą. Przekreślone, z datą, powodem (jeśli bot go podał) i zamiennikiem.
- Wszystko - jedno i drugie na jednej liście.
Cofanie błędnej decyzji
Bot czasem się myli. Przywróć w wierszu wycofanego faktu otwiera go ponownie jednym kliknięciem - po to właśnie wiersz został zachowany zamiast usunięty. Zamiennik, jeśli był, celowo zostaje nietknięty: dwa fakty mogą być prawdziwe jednocześnie, a to, który z nich odpada, jest Twoją decyzją, a nie panelu.
Usuń nadal usuwa, w wierszu wycofanym tak samo jak w każdym innym. Osoba usuwająca fakt z tej strony podjęła decyzję; nic jej nie podważa.
Przełączanie i powrót
Włączenie typu Journal niczego nie przenosi. Każdy fakt, który już masz, uznawany jest za nadal prawdziwy - czym już był - i zachowuje datę utworzenia.
Powrót do typu Classic zostawia wszystko, co w międzyczasie zostało wycofane, dokładnie tam, gdzie jest: nadal na tej stronie, nadal niewidoczne dla bota. Jeśli chcesz, by wszystko wróciło przed oczy AI, strona Pamięć oferuje dla tego jednego serwera przycisk Przywróć wszystkie wycofane fakty i zapisuje to w Twoim dzienniku audytu. Nigdy nie dzieje się to samo: to, co dziennik wycofał, wycofał z jakiegoś powodu.
🔎 Przeszukiwalne archiwum - bot może coś wyszukać
Pamięć Classic ma jedno realne ograniczenie i nie jest nim liczba faktów, które możesz przechowywać. Chodzi o to, że wszystko ponad Maksymalna liczba wstrzykiwanych wspomnień jest dla AI niewidoczne, choćby było prawdziwe. Podniesienie limitu to jedyna dźwignia, a sprawia ona, że każda wiadomość kosztuje więcej.
Przeszukiwalne archiwum daje botowi drugą dźwignię. Ostatnie fakty są mu przekazywane jak zwykle, a dodatkowo może poprosić o jeden z nich po nazwie - „wyszukaj w pamięci: urodziny Pawła”. To, co znajdzie, dostaje przed udzieleniem odpowiedzi.
Ile to kosztuje
Nic w wiadomościach, w których bot niczego nie wyszukuje, a to większość z nich. Gdy już coś wyszukuje, kosztuje to dokładnie jedno dodatkowe wywołanie AI - pytanie jest zadawane ponownie, tym razem z faktami w ręku. Nigdy dwa: bot, który w drugiej odpowiedzi znów prosi o wyszukiwanie, jest ignorowany.
Samo wyszukiwanie to wyszukiwanie pełnotekstowe, wykonywane przez bazę danych. Bez embeddingów, bez wektorów, bez niczego liczonego przy każdej wiadomości i bez udziału usług zewnętrznych.
Do czego sięga
Do każdego faktu tego serwera, który jest nadal w użyciu, w obu zakresach - faktów o serwerze i faktów o jego członkach. To celowe: „urodziny Pawła” to fakt o kimś, kto nie jest osobą piszącą, a wyszukiwanie, które sięgałoby tylko do faktów mówiącego, ominęłoby większość pytań wartych zadania.
Do czego nie sięga: do niczego, co zostało wycofane w typie Journal - zamknięcie okresu obowiązywania faktu to właśnie decyzja, by go nie oddawać - ani do niczego z kanału, na którym odczyt pamięci nie jest dozwolony. Wyszukiwanie to odczyt i podlega temu samemu ustawieniu Kanały, na których pamięć może być ODCZYTANA.
Fakt, który bot znalazł wyszukiwaniem, jest też faktem, który może poprawić, na tych samych zasadach co fakty, które mu przekazano.
Zanim przełączysz: próba na sucho
Gdy wybrany jest jeden serwer, strona Pamięć mówi Ci, ile kosztowałoby Cię archiwum, w liczbach z Twoich własnych danych: ile faktów jest do zaindeksowania, ile to tekstu i jak długo trwało właśnie prawdziwe wyszukiwanie w nich.
Włączenie niczego nie przenosi ani nie przepisuje. Indeks jest zbudowany na tekście, który już jest zapisany, i istnieje dla każdego serwera, niezależnie od tego, czy wyszukuje - więc przełączanie i powrót są w obie strony natychmiastowe.
🏅 Pamięć rankingowa - miejsca zajmują fakty, które na nie zasługują
Pamięć Classic przekazuje modelowi ostatnich N zmodyfikowanych faktów. Innymi słowy: zasada, według której serwer żyje od roku, traci miejsce na rzecz wczorajszej pogawędki, bo pogawędkę ruszono niedawno.
Pamięć rankingowa ocenia każdy fakt-kandydata według trzech kryteriów i przekazuje najlepsze N:
- Jak jest świeży.
- Jak jest ważny - oceniany przez model w chwili zapisywania faktu, czyli w jedynym momencie, w którym powód zapisu jest jeszcze przed jego oczami.
- Jak bardzo ma związek z tym, co jest właśnie mówione.
To ranking, a nie filtr. Nic nie jest odkładane na zawsze, a fakt, który nie załapie się przy jednej wiadomości, jest znów kandydatem przy następnej.
Wagi są Twoje
Trzy ustawienia na stronie Odpowiedzi AI - świeżość, ważność, trafność - decydują, ile liczy się każde z kryteriów, osobno dla serwera. Serwer, którego pamięć to głównie obowiązujące zasady, będzie chciał, by ważność liczyła się bardziej niż świeżość; ruchliwy serwer towarzyski zechce odwrotnie.
Odczytywana jest też pewność zapisana z każdym faktem. Działa jak mnożnik i tylko w dół: fakt, co do którego bot nie był pewien, nie wyprzedzi tego, co do którego był pewny.
Przełączenie nic nie kosztuje
Nie ma migracji ani rachunku. Fakt, którego nikt jeszcze nie ocenił, trafia na środek rankingu, a nie na koniec, więc ranking działa od pierwszej wiadomości na tym, co już masz, a ważność uzupełnia się sama, gdy bot przepisuje fakty.
Próba na sucho mówi, ile Twoich faktów ma już ocenę, i pokazuje, które zyskałyby miejsce, a które by je straciły.
🧩 Pamięć skonsolidowana - porządki dzieją się, gdy serwer jest spokojny
Rosnąca pamięć w końcu mówi to samo dwa razy pod dwiema nazwami: language z jednej strony, lang z drugiej. Dotąd jedynym sposobem, by sobie z tym poradzić, była praca ręczna.
Pamięć skonsolidowana dodaje przebieg w tle po pamięci serwera, który ucichł. Nigdy nie działa w trakcie odpowiedzi i - to ważna część - sam niczego nie stosuje.
Proponuje, Ty decydujesz
Przebieg zapisuje propozycje. Pojawiają się na stronie Pamięć jedna po drugiej, z faktem, który zostaje, obok faktu, który by zastąpił, a każda ma trzy możliwe odpowiedzi:
- Scal - przyjmij sugestię przebiegu.
- Scal w drugą stronę - zachowaj zamiast tego drugi fakt. Przy dwóch faktach, które się nie zgadzają, to Ty wiesz, który jest nadal prawdziwy.
- Zachowaj oba - odrzuć. Przebieg nie zapyta ponownie, chyba że któryś z dwóch faktów zostanie później przepisany.
Nic się nie zmienia, dopóki nie klikniesz jednej z tych odpowiedzi.
Zgoda nigdy nie wymazuje
Scalenie to zastąpienie w rozumieniu Journal. Fakt, który ustępuje, zamyka swój okres obowiązywania, wskazując na ten, który został, pojawia się na tej stronie przekreślony z datą i powodem, a Przywróć go cofa. Scalenie cofa się dokładnie tak jak każde inne wycofanie.
Sprzeczności nigdy nie są scalane. Dwa fakty, które mówią coś przeciwnego, są oznaczane do rozstrzygnięcia przez człowieka. Nic w przebiegu nie wie, który z nich jest nadal prawdziwy.
Podsumowanie jest przepisywane
Podsumowanie to jedyny wiersz pamięci, który bot czyta w całości, za każdym razem - więc to także wiersz, który starzeje się najszybciej. Został napisany raz, z tego, co było wtedy wiadomo.
Przebieg przygotowuje szkic tego, co powiedziałby dzisiaj, na podstawie faktów dotyczących całego serwera, a strona zestawia oba obok siebie: Co bot czyta dzisiaj i Co czytałby zamiast tego. Ta sama zasada co przy scaleniu - nic tego nie zastąpi bez Twojej zgody, a poprzednie brzmienie jest wycofywane, a nie usuwane.
Własny model
Ten przebieg nie ściga się z odpowiedzią na Discordzie, więc może działać na mocniejszym albo tańszym modelu niż ten, który odpowiada na kanale - z własnym endpointem i własnym kluczem, jak każde pole modelu w panelu.
Działa też bez żadnego modelu. Bez niego przebieg nadal znajduje i proponuje każdą parę; scalenie po prostu zachowuje zwycięski fakt słowo w słowo, zamiast przepisywać dwa w jedno zdanie. Model pisze zawsze tylko sugerowane brzmienie i szkic podsumowania.
Kiedy działa
Według własnego harmonogramu i sam odmawia, gdy przebieg by się nie opłacał: pamięć zbyt mała, by zawierać duplikaty, nic się nie zmieniło od ostatniego przebiegu, od poprzedniego minęło mniej niż doba albo jakaś propozycja już czeka na odpowiedź. Serwer, który nigdy nie ucichnie, i tak dostaje swój przebieg po tygodniu, bo to właśnie ten serwer ma pamięć zapełniającą się duplikatami.
Zanim przełączysz: próba na sucho
Karta mówi, na Twoich własnych danych, ile faktów jest zapisanych, ile duplikatów i ile sprzeczności znalazłby przebieg, wraz z pięcioma prawdziwymi przykładami z Twojego serwera.
Włączenie niczego nie przenosi. Pierwszy przebieg proponuje; Ty decydujesz.
🧠 Pamięć semantyczna - znaczenie zamiast słów
Każdy typ przed tym odpowiada pod spodem na to samo pytanie: czy te dwa teksty mają wspólne słowa? Dla „mówi po francusku” i „językiem serwera jest francuski” odpowiedź brzmi: nie - jedno wspólne słowo, i to nie to użyteczne.
Pamięć semantyczna zamienia każdy fakt w embedding: kierunek zamiast ciągu znaków. Dwa fakty, które znaczą to samo, wskazują w tę samą stronę, niezależnie od użytych słów, a bliskość między nimi jest liczbą, którą panel może porównać.
Co się faktycznie zmienia
Dwie rzeczy, a druga jest tą, którą czujesz na co dzień.
Wyszukiwanie przestaje coś pomijać. Gdy bot szuka faktu, którego mu nie podano, przestaje zależeć od tego, czy członek użył tego samego słowa co osoba, która fakt zapisała.
Ranking przestaje zależeć od słów wiadomości. W typie Rankingowym fakt zyskuje trafność z tego, gdzie wylądował w wynikach wyszukiwania. W Semantycznym ocenia się go według tego, jak naprawdę blisko jest tego, co jest mówione - to różnica między „ten fakt został znaleziony” a „ten fakt jest o tym”.
Ile to kosztuje
To jedyny typ, który cyklicznie wysyła Twoje dane gdzieś dalej, więc warto jasno powiedzieć o kosztach:
- Jedno wywołanie embeddingu na zapisany fakt, jednorazowo. Fakt, który nie jest przeredagowywany, nigdy nie jest osadzany dwa razy.
- Jedno wywołanie na wiadomość wystarczająco długą, by ją uwzględnić w rankingu. Poniżej dwunastu znaków nic nie jest wysyłane - „lol” nie ma do czego się dopasować.
- Samo porównanie odbywa się w panelu, nie w bazie danych, dlatego typ dobrze działa do kilku tysięcy faktów na serwerze i niewiele dalej.
Wymaga modelu embeddingów, nazwanego na tym samym endpoincie i z tym samym kluczem co reszta Twoich ustawień AI.
Wraca sam do poprzedniego trybu
Brak nazwanego modelu, endpoint, który odmawia, przebieg nadrabiający zaległości, który jeszcze nie ruszył, albo właśnie zmieniony model embeddingów - w każdym z tych przypadków wyszukiwanie wraca do dopasowywania słów zamiast się wywracać. Odpowiedź mówi, który z dwóch trybów faktycznie zadziałał, więc ciche przejście na zapasowy tryb pozostaje widoczne.
Zmiana modelu embeddingów powoduje ponowne osadzenie wszystkiego, a dopóki ten przebieg się nie skończy, serwer wyszukuje według słów. W międzyczasie nic się nie psuje.
Zanim przełączysz: próba na sucho
Karta mówi, ile wywołań wykonałby przebieg nadrabiający zaległości, na ilu tekstu i które z Twoich faktów wektory uznają już za tę samą rzecz.
Żadnej ceny w walucie. Podanie kwoty oznaczałoby wymyślenie taryfy dla dowolnego wskazanego endpointu, a zmyślona liczba na stronie o pieniądzach jest gorsza niż brak liczby.
🧹 Czyszczenie pamięci
Usuwanie wpisów pojedynczo jest dobre przy jednym błędnym fakcie. W dwóch innych przypadkach jest Wyczyść pamięć, obok filtra serwera, gdy wybierzesz jeden serwer:
- Wszystko o tym serwerze - gdy pamięć odpłynęła na tyle, że zacząć od nowa jest lepiej niż poprawiać dwadzieścia wpisów.
- Wszystko o jednym członku - gdy ktoś odszedł albo prosi o zapomnienie. Wpisz jego ID użytkownika Discord.
Dzieje się to natychmiast i nie da się tego cofnąć, a bot zaczyna uczyć się na nowo od następnej rozmowy. Każde czyszczenie jest zapisywane w Twoim dzienniku audytu pod nazwą osoby, która go dokonała, z liczbą usuniętych wpisów.
🔑 Kontrola dostępu
Wpisy pamięci są widoczne dla każdego, kto ma dostęp do zespołu będącego właścicielem serwera.
Zmienianie ich to inne uprawnienie: dodawanie, edytowanie, usuwanie i czyszczenie wymagają uprawnienia do konfigurowania serwera - tego samego, którego wymagają ustawienia funkcji. Bez niego nadal możesz czytać listę, a przycisk Wyczyść pamięć po prostu się nie pojawia.
Nie przechowuj w pamięci AI poufnych sekretów, haseł, prywatnych tokenów ani informacji poufnych.
🧵 Wątki
Odczyt i zapis pamięci podlegają ustawieniom Kanały, na których pamięć może być ODCZYTANA i Kanały, na których pamięć może być ZAPISANA, a wątek nie jest jednym z tych kanałów, nawet jeśli jest nim kanał, w którym został otwarty. Domyślnie pamięć nie jest w wątkach ani odczytywana, ani zapisywana. Opcja Uwzględnij wątki w Odpowiedziach AI (domyślnie wyłączona) sprawia, że wątek podlega tym samym zasadom co kanał, w którym został założony; zobacz Odpowiedzi AI. Zostaw ją wyłączoną, jeśli wątek może być otwarty dla osób, które nie powinny widzieć, co zawiera pamięć.
✨ Pamięć a jakość odpowiedzi
Więcej pamięci nie zawsze znaczy lepiej.
Zbyt wiele nieistotnych faktów może sprawić, że AI będzie mniej skupione.
Dobra pamięć powinna być:
- Krótka
- Dokładna
- Istotna
- Aktualna
- Łatwa do zrozumienia
💡 Dobre praktyki
- Przeglądaj pamięć po większych zmianach na serwerze.
- Usuwaj nieaktualne fakty.
- Wyczyść wpisy członka, gdy prosi o zapomnienie, zamiast szukać jego wierszy.
- Utrzymuj ważne zasady jasne i jednoznaczne.
- Nie przechowuj prywatnych danych użytkowników, chyba że masz dobry powód i zgodę.
- Używaj pamięci do poprawy kontekstu, a nie do zastępowania moderacji czy oceny zespołu.