Met AI-geheugen kan YAWBDB nuttige context over een server bewaren, zodat AI-antwoorden na verloop van tijd consistenter worden.
Er schrijven twee partijen in: jij, vanuit het panel, en de bot, die noteert wat hij leert uit gesprekken op Discord. Het geheugensysteem beheer je vanuit het panel, en er wordt nooit iets automatisch uit verwijderd.
🧠 Waarvoor geheugen dient
Geheugen kan de AI helpen om informatie te onthouden zoals:
- Server-lore
- Feiten over de community
- Gewenste toon
- Terugkerende grappen
- Context over gebruikers of rollen
- Terminologie die specifiek is voor de server
- Belangrijke regels of herinneringen
Het doel is dat AI-antwoorden meer bij de server lijken te passen.
📒 Geheugenpagina
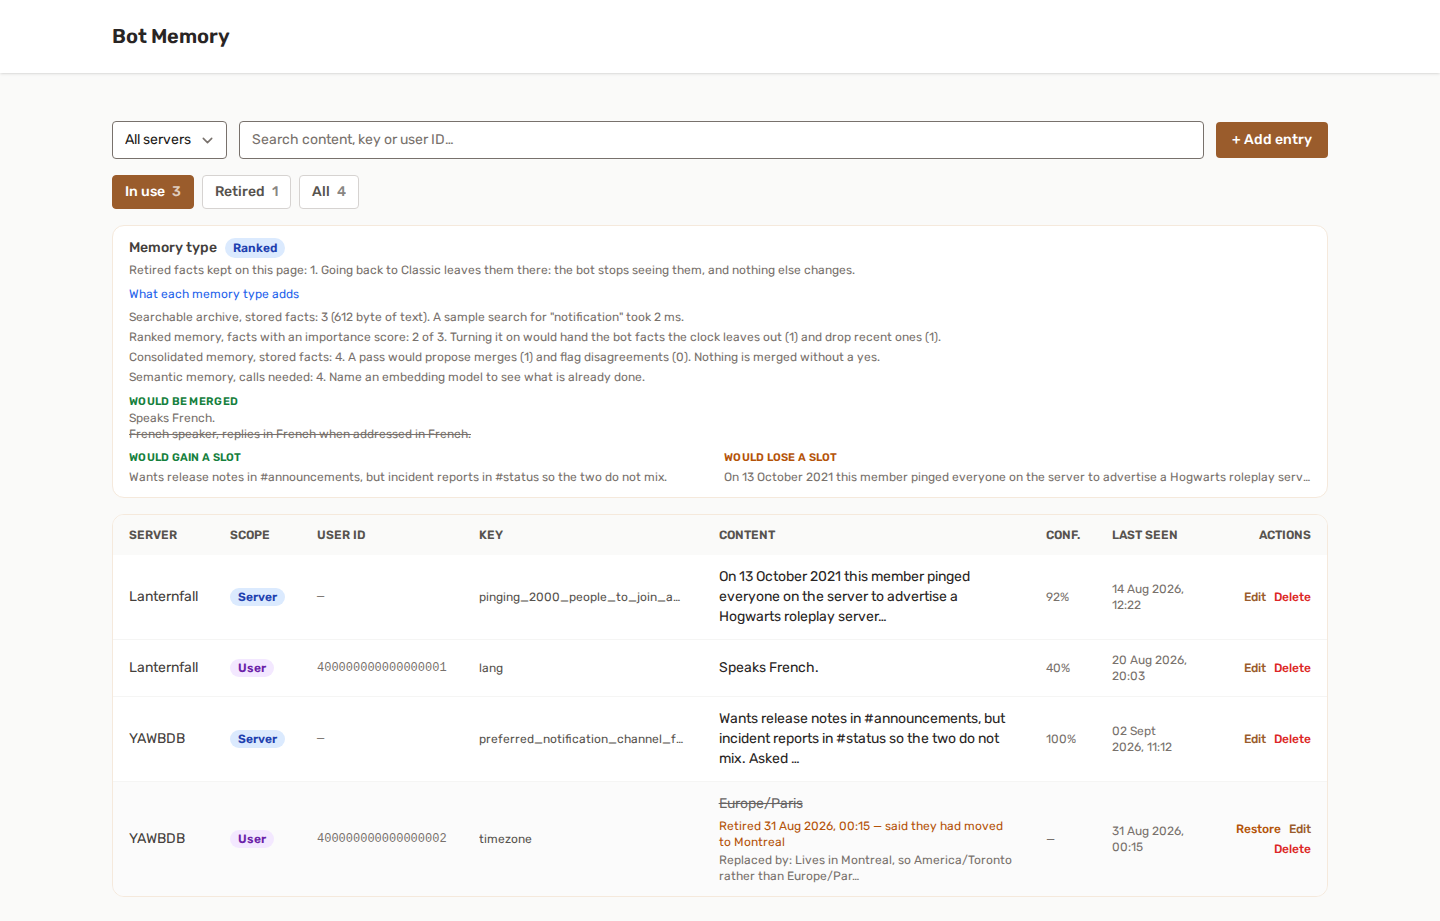
De geheugenpagina geeft bevoegde gebruikers een volledig overzicht van de opgeslagen geheugenitems.
Op deze pagina kun je:
- Geheugen per server bekijken
- Zoeken op sleutel of inhoud
- Handmatig nieuwe herinneringen toevoegen
- Bestaande herinneringen bewerken
- Verouderde herinneringen verwijderen
- Betrouwbaarheidswaarden nakijken
🔎 Filteren en paginering
Het geheugen kan per server worden gefilterd en direct worden doorzocht.
Grote geheugensets worden over meerdere pagina's verdeeld, zodat de pagina bruikbaar blijft.
✍️ Handmatige geheugenitems
Je kunt handmatig geheugenitems toevoegen als je wilt dat de AI iets specifieks weet.
Voorbeelden:
server_theme: This server is about retro gaming.bot_tone: Replies should be friendly and concise.important_rule: Do not give support in public channels; direct users to tickets.
Gebruik korte, duidelijke items. Dump geen enorme alinea's, tenzij het echt nodig is.
✏️ Geheugen bewerken
Je kunt bewerken:
- Sleutel
- Inhoud
- Betrouwbaarheid
Bewerk een herinnering als ze nog nuttig is maar gecorrigeerd moet worden.
Verwijder haar als ze verouderd is of niet meer relevant.
♻️ Niets wordt achter je rug om vergeten
Items worden nooit automatisch verwijderd. Er is geen vervaldatum en geen opruimtaak: een feit blijft staan tot de bot zelf besluit dat het niet meer klopt, of tot iemand het van deze pagina verwijdert.
Wat jij bepaalt, is hoeveel ervan de AI bereikt. Maximumaantal ingevoegde geheugenitems, op de instellingenpagina van AI-reacties, bepaalt hoeveel feiten er als context worden meegestuurd: van 1 tot 1000, standaard 20. Een hogere waarde geeft de AI meer om mee te werken; een lagere houdt antwoorden compacter. Hoe dan ook wordt er niets verwijderd, dus je kunt de waarde vrij omhoog en omlaag zetten.
Leeftijd is geen reden om te vergeten. Deze server spreekt Frans is na twee jaar nog steeds waar, en niemand zal het opnieuw vastleggen.
Hoe de bot beslist
Elk feit dat naar het model wordt gestuurd, draagt zijn eigen nummer, in de context die het ontvangt weergegeven als [#12]. Als de bot concludeert dat iets niet meer klopt - een regel die is veranderd, een voorkeur die iemand heeft teruggedraaid - antwoordt hij met dat nummer, en het item wordt niet meer gebruikt. Of het dan wordt verwijderd of bewaard om te lezen, hangt af van het geheugentype, hieronder.
Hij kan alleen een feit weghalen dat hij in die uitwisseling echt te zien kreeg. Noemt hij een nummer dat hij niet voor zich had, dan gebeurt er niets: een geraden nummer kan geen feit uit een ander gesprek bereiken, zelfs geen bestaand feit van dezelfde server.
Daarom is Maximumaantal ingevoegde geheugenitems dubbel belangrijk. Een feit dat nooit bij het model aankomt, kan door het model ook nooit opnieuw worden bekeken - het blijft staan tot iemand het van deze pagina verwijdert. Met het doorzoekbare archief is dat geen doodlopende weg meer: een feit dat de bot opzoekt, is ook een feit dat hij kan corrigeren.
🧭 Een geheugentype kiezen
Geheugentype is één keuze per server, die je maakt op deze geheugenpagina - niet op de instellingenpagina van AI-reacties. Het bepaalt hoe de bot opslaat wat hij weet en hoe hij het terugvindt, en het wordt opgeslagen zodra je klikt. Het is geen keuzelijst: klik erop en de zes types openen zich naast elkaar over de pagina, elk met wat het doet, wat het verandert, wat overstappen ernaartoe zou verplaatsen en waar je meer kunt lezen.
Bovenaan de pagina staan de zes types getekend als één schaal, met de positie van je eigen server erop aangegeven, nog voordat je de keuzelijst opent.
De instellingenpagina van AI Response bevat nog steeds de instellingen die bij het actieve type horen - de rangschikkingsgewichten (recentheid, belangrijkheid, relevantie), hoeveel feiten er worden ingevoegd, en de modellen voor de consolidatieronde op de achtergrond en voor de semantische embeddings. Deze pagina zegt je precies waar elk van die instellingen staat, zodat je er nooit naar hoeft te zoeken.
Classic is wat er nu draait en is de standaard. Een server die dit veld nooit opent, blijft zich precies gedragen zoals altijd: een platte lijst met feiten, waarvan de laatst bijgewerkte in elk antwoord worden ingevoegd, en niets wordt uit zichzelf verwijderd.
De andere vijf voegen elk één ding toe aan het vorige, en ze worden in volgorde gebouwd:
- Logboek - nu beschikbaar. Een feit dat niet meer waar is, wordt ingetrokken in plaats van gewist, zodat je nog kunt lezen wat er stond. Zie de volgende sectie.
- Doorzoekbaar archief - nu beschikbaar. De bot mag iets opzoeken in plaats van alleen de feiten te gebruiken die hij kreeg aangereikt, zodat wat voorbij je ingestelde limiet valt niet meer onzichtbaar is. Zie de sectie daarna.
- Gerangschikt geheugen - nu beschikbaar. De plekken gaan naar de nuttigste feiten, niet alleen naar de nieuwste.
- Geconsolideerd geheugen - nu beschikbaar. Een ronde op de achtergrond voegt duplicaten samen en herschrijft de samenvatting zolang de server rustig is, en legt elk van die wijzigingen aan jou voor ter goedkeuring.
- Semantisch geheugen - zoeken op betekenis in plaats van op woorden, zodat "hij spreekt Frans" "de taal van de server is Frans" vindt. Het sterkste van de zes, en het enige met een rekening eraan.
Het type dat nog niet klaar is, staat zo aangegeven in het dialoogvenster en kan niet worden geselecteerd. Welk type je ook kiest, dezelfde twee regels gelden: ze lezen allemaal hetzelfde geheugen, en geen van hen verwijdert uit zichzelf iets - dus van gedachten veranderen, en weer terugschakelen, kost je nooit een feit.
Als je één server hebt gekozen, laat de geheugenpagina je in aantallen zien wat een wijziging werkelijk zou verplaatsen, voordat je haar doorvoert.
📓 Logboek - niets wordt gewist, alleen ingetrokken
Onder Logboek verwijdert de bot een feit dat hij verouderd vindt niet meer. De geldigheidsperiode van het feit eindigt gewoon: het verdwijnt uit de context die de AI krijgt, en blijft op deze pagina staan met de datum waarop het ophield en, als die er is, het feit dat zijn plaats innam.
Daar hoort ook een extra mogelijkheid bij. In plaats van alleen [#12] te kunnen laten vallen, kan de bot zeggen "dit klopt niet meer, dit komt ervoor in de plaats" - en hem wordt met zoveel woorden verteld dat de oude formulering bewaard blijft. Een correctie waarvan hij denkt dat ze destructief is, is een correctie waar hij mee aarzelt.
De geschiedenis lezen
Zodra er iets is ingetrokken, verschijnen er drie tabbladen boven de tabel:
- Van kracht - wat de bot echt kan zien. Dit is de standaard, en het is het echte antwoord van de pagina op "wat weet de bot?".
- Ingetrokken - wat vroeger waar was. Doorgestreept, met de datum, de reden als de bot er een gaf, en de vervanger.
- Alles - beide, in één lijst.
Een verkeerde beslissing ongedaan maken
De bot vergist zich soms. Herstellen, op een ingetrokken rij, heropent die met één klik - dat is de hele reden dat de rij is bewaard in plaats van verwijderd. De vervanger, als die er was, blijft bewust met rust gelaten: twee feiten kunnen tegelijk waar zijn, en welke van de twee verdwijnt, bepaal jij en niet het panel.
Verwijderen verwijdert nog steeds, op een ingetrokken rij net als op elke andere. Wie een feit van deze pagina haalt, heeft besloten; niets twijfelt dat nog aan.
Overstappen en terugschakelen
Logboek aanzetten verplaatst niets. Elk feit dat je al hebt, geldt als nog waar - en dat was het al - en behoudt de datum waarop het is aangemaakt.
Terugschakelen naar Classic laat alles wat intussen is ingetrokken precies waar het is: nog op deze pagina, nog steeds niet gezien door de bot. Wil je alles weer voor de AI hebben, dan biedt de geheugenpagina Alle ingetrokken feiten herstellen voor die ene server, en schrijft ze dat weg in je auditlogboek. Het wordt nooit voor je gedaan: wat het logboek heeft ingetrokken, heeft het om een reden ingetrokken.
🔎 Doorzoekbaar archief - de bot kan dingen opzoeken
Classic-geheugen heeft één echte beperking, en dat is niet het aantal feiten dat je mag opslaan. Het is dat alles voorbij Maximumaantal ingevoegde geheugenitems onzichtbaar is voor de AI, hoe waar het ook is. De limiet verhogen is de enige hefboom, en het maakt elk afzonderlijk bericht duurder.
Doorzoekbaar archief geeft de bot de andere hefboom. De recente feiten krijgt hij zoals gewoonlijk aangereikt, en daarbovenop mag hij er één bij naam opvragen - "zoek in het geheugen naar: Pauls verjaardag". Wat hij vindt, krijgt hij voordat hij antwoordt.
Wat het kost
Niets bij de berichten waarbij de bot niets opzoekt, en dat zijn de meeste. Als hij wel iets opzoekt, kost het precies één extra aanroep naar de AI - de vraag wordt opnieuw gesteld met de feiten bij de hand. Nooit twee: een bot die in zijn tweede antwoord opnieuw vraagt om te zoeken, wordt genegeerd.
De zoekopdracht zelf is volledige tekst, uitgevoerd door de database. Geen embeddings, geen vectoren, niets dat per bericht wordt berekend, en geen externe dienst erbij.
Wat hij kan bereiken
Elk feit van die server dat nog in gebruik is, in beide bereiken - feiten over de server en feiten over de leden. Dat is bewust: "Pauls verjaardag" is een feit over iemand die niet degene is die praat, en een zoekopdracht die alleen de eigen feiten van de spreker kon bereiken, zou de meeste vragen die het waard zijn om te stellen missen.
Wat hij niet kan bereiken: alles wat onder een logboek is ingetrokken - het venster van een feit sluiten is nu juist het besluit om het niet terug te geven - en alles in een kanaal waar het lezen van geheugen niet is toegestaan. Een zoekopdracht is een leesactie en gehoorzaamt aan dezelfde instelling Kanalen waar het geheugen mag worden GELEZEN.
Een feit dat de bot al zoekend heeft gevonden, mag hij ook corrigeren, onder dezelfde voorwaarden als de feiten die hij kreeg aangereikt.
Voordat je overstapt: de proefrun
Als je één server hebt gekozen, laat de geheugenpagina zien wat het archief je zou kosten, in cijfers uit je eigen data: hoeveel feiten er te indexeren zijn, hoeveel tekst dat is, en hoelang een echte zoekopdracht daarover net duurde.
Aanzetten verplaatst niets en herschrijft niets. De index wordt gebouwd over de tekst die al is opgeslagen, en hij bestaat voor elke server, of ze nu zoeken of niet - dus overstappen en terugschakelen gaat in beide richtingen meteen.
🏅 Gerangschikt geheugen - de plekken gaan naar de feiten die het waard zijn
Classic-geheugen geeft het model de laatste N gewijzigde feiten. Anders gezegd: een regel waar je server al een jaar naar leeft, verliest zijn plek aan het kleine praatje van gisteren, omdat daar recenter aan is gezeten.
Gerangschikt geheugen geeft elk kandidaat-feit een score op drie punten en levert in plaats daarvan de beste N:
- Hoe recent het is.
- Hoe belangrijk het is - beoordeeld door het model op het moment dat het het feit schrijft, het enige moment waarop de reden om het op te slaan nog voor zijn neus ligt.
- Hoeveel het te maken heeft met wat er nu wordt gezegd.
Het is een rangschikking, geen filter. Niets wordt voorgoed opzijgezet, en een feit dat bij het ene bericht de cut mist, is bij het volgende weer een kandidaat.
De gewichten zijn van jou
Drie instellingen op de pagina van AI-reacties - recentheid, belangrijkheid, relevantie - bepalen hoe zwaar elk onderdeel meetelt, per server. Een server waarvan het geheugen vooral vaste regels bevat, wil dat belangrijkheid zwaarder weegt dan versheid; een drukke sociale server wil het omgekeerde.
De betrouwbaarheid die al bij elk feit is opgeslagen, wordt ook meegelezen. Die werkt als een vermenigvuldiger, en alleen naar beneden: een feit waar de bot onzeker over was, komt niet boven een feit waar hij zeker van was.
Overstappen kost niets
Er is geen migratie en geen rekening. Een feit dat nog niemand een score heeft gegeven, komt in het midden en niet onderaan, zodat de rangschikking vanaf het eerste bericht werkt op wat je al hebt, en de belangrijkheid zich vanzelf aanvult naarmate de bot feiten herschrijft.
De proefrun zegt hoeveel van je feiten al een score hebben, en laat zien welke een plek zouden winnen en welke er een zouden verliezen.
🧩 Geconsolideerd geheugen - het opruimen gebeurt zolang de server rustig is
Een geheugen dat groeit, zegt uiteindelijk twee keer hetzelfde onder twee namen: language aan de ene kant, lang aan de andere. Tot nu toe was de enige manier om daar iets aan te doen met de hand.
Geconsolideerd geheugen voegt een ronde op de achtergrond toe over het geheugen van een server die rustig is geworden. Hij draait nooit midden in een antwoord, en - dit is het belangrijkste - hij past zelf niets toe.
Hij stelt voor, jij beslist
De ronde schrijft voorstellen. Ze verschijnen één voor één op de geheugenpagina, het feit dat blijft naast het feit dat het zou vervangen, en elk voorstel heeft drie antwoorden:
- Samenvoegen - neem de suggestie van de ronde over.
- Andersom samenvoegen - houd in plaats daarvan het andere feit. Bij twee feiten die elkaar tegenspreken, ben jij degene die weet welke nog waar is.
- Allebei houden - afwijzen. De ronde vraagt er niet opnieuw naar, tenzij een van de twee feiten daarna wordt herschreven.
Er verandert niets totdat op een van die knoppen wordt geklikt.
Een ja wist nooit iets
Een samenvoeging is een vervanging in de zin van het logboek. Het feit dat opzijgaat, sluit zijn venster met een verwijzing naar het feit dat blijft, het verschijnt doorgestreept op deze pagina met zijn datum en zijn reden, en Herstellen brengt het terug. Een samenvoeging maak je op precies dezelfde manier ongedaan als elke andere intrekking.
Tegenstrijdigheden worden nooit samengevoegd. Twee feiten die het tegenovergestelde zeggen, worden gemarkeerd zodat een mens het beslecht. Niets in de ronde weet welke van de twee nog waar is.
De samenvatting wordt herschreven
De samenvatting is de ene geheugenrij die de bot elke keer in zijn geheel leest - dus ook de rij die als eerste verouderd raakt. Ze is eenmalig geschreven, op basis van wat er toen bekend was.
De ronde maakt een concept van wat ze vandaag zou zeggen op basis van de feiten voor de hele server, en de pagina zet de twee naast elkaar: wat de bot vandaag leest, en wat hij in plaats daarvan zou lezen. Dezelfde regel als bij een samenvoeging: niets vervangt haar zonder een ja, en de vorige formulering wordt ingetrokken in plaats van verwijderd.
Een eigen model
Deze ronde moet niet opboksen tegen de snelheid van een Discord-antwoord, dus ze kan draaien op een sterker of een goedkoper model dan het model dat in het kanaal antwoordt - met een eigen endpoint en een eigen sleutel, zoals elk modelveld in het panel.
Ze werkt ook zonder enig model. Zonder model vindt en stelt de ronde nog steeds elk paar voor; een samenvoeging houdt dan gewoon het winnende feit woord voor woord, in plaats van de twee in één zin te herschrijven. Het model schrijft alleen de voorgestelde formulering en het concept van de samenvatting.
Wanneer ze draait
Op haar eigen schema, en ze weigert zichzelf wanneer een ronde niets zou opleveren: een geheugen dat te klein is om duplicaten te bevatten, niets veranderd sinds de vorige ronde, minder dan een dag sinds de vorige, of een voorstel dat al op antwoord wacht. Een server die nooit rustig is, krijgt na een week toch zijn ronde, want dat is precies de server waarvan het geheugen volloopt met duplicaten.
Voordat je overstapt: de proefrun
De kaart vertelt je, op je eigen data, hoeveel feiten er zijn opgeslagen, hoeveel duplicaten en hoeveel tegenstrijdigheden een ronde zou vinden, met vijf echte voorbeelden uit je server.
Aanzetten verplaatst niets. De eerste ronde stelt voor; jij beslist.
🧠 Semantisch geheugen - betekenis in plaats van woorden
Elk type vóór dit beantwoordt onderliggend dezelfde vraag: hebben deze twee teksten woorden gemeen? Voor "hij spreekt Frans" en "de taal van de server is Frans" is het antwoord nee - één woord gemeen, en niet het nuttige.
Semantisch geheugen maakt van elk feit een embedding: een richting in plaats van een tekenreeks. Twee feiten met dezelfde betekenis wijzen dezelfde kant op, met welke woorden ze ook zijn geschreven, en de nabijheid tussen beide is een getal dat het panel kan vergelijken.
Wat er echt verandert
Twee dingen, en het tweede merk je elke dag.
De zoekopdracht mist niets meer. Als de bot een feit gaat zoeken dat hij niet kreeg aangereikt, hangt hij er niet meer van af dat het lid hetzelfde woord gebruikte als degene die het feit heeft opgeschreven.
De rangschikking hangt niet meer af van de woorden van het bericht. Onder Gerangschikt krijgt een feit een relevantiescore op basis van waar het in de zoekresultaten terechtkwam. Onder Semantisch wordt het gescoord op hoe dicht het werkelijk bij het gezegde ligt - het verschil tussen "dit feit is gevonden" en "dit feit gaat hierover".
Wat het kost
Dit is het enige type dat je data volgens een schema ergens naartoe stuurt, dus de kosten zijn het waard om helder te benoemen:
- Eén embedding-aanroep per geschreven feit, eenmalig. Een feit dat niet wordt herschreven, wordt nooit twee keer geëmbed.
- Eén aanroep per bericht dat lang genoeg is om tegen te rangschikken. Onder twaalf tekens wordt er niets verstuurd - "lol" heeft niets om mee te matchen.
- De vergelijking zelf gebeurt in het panel, niet in de database, en daarom is het type comfortabel tot een paar duizend feiten op een server en niet veel verder.
Het heeft een embeddingmodel nodig, op te geven op hetzelfde endpoint en met dezelfde sleutel als de rest van je AI-instellingen.
Het valt vanzelf terug
Geen model opgegeven, een endpoint dat weigert, een inhaalronde die nog niet heeft gedraaid, of een embeddingmodel dat je net hebt gewijzigd - in elk van die gevallen schakelt de zoekopdracht terug naar het matchen van woorden in plaats van te mislukken. Het antwoord zegt welke van de twee echt is gebruikt, zodat een stille terugval zichtbaar blijft.
Als je je embeddingmodel wijzigt, wordt alles opnieuw geëmbed, en tot die ronde klaar is zoekt de server op woorden. Er gaat ondertussen niets stuk.
Voordat je overstapt: de proefrun
De kaart vertelt je hoeveel aanroepen de inhaalronde zou doen, over hoeveel tekst, en welke van je feiten de vectoren al als hetzelfde beschouwen.
Geen prijs in geld. Daar een bedrag neerzetten zou betekenen dat we een tarief verzinnen voor het endpoint dat je hebt opgegeven, en een verzonnen getal op een pagina over geld is erger dan helemaal geen getal.
🧹 Geheugen wissen
Items één voor één verwijderen is goed voor één verkeerd feit. Voor twee andere gevallen is er Geheugen wissen, naast het serverfilter zodra je één server hebt gekozen:
- Alles over deze server - als het geheugen zo ver is afgedwaald dat opnieuw beginnen beter is dan twintig correcties.
- Alles over één lid - als iemand is weggegaan, of vraagt om vergeten te worden. Vul zijn Discord-gebruikers-id in.
Het gebeurt meteen en kan niet ongedaan worden gemaakt, en de bot begint weer te leren vanaf het volgende gesprek. Elke wisactie wordt in je auditlogboek vastgelegd onder de naam van wie het deed, met hoeveel items er zijn verdwenen.
🔑 Toegangscontrole
Geheugenitems zijn zichtbaar voor iedereen met toegang tot het team dat de server bezit.
Ze wijzigen is een ander recht: toevoegen, bewerken, verwijderen en wissen vereisen allemaal toestemming om de server te configureren - dezelfde als voor de functie-instellingen. Zonder die toestemming kun je de lijst nog steeds lezen, en de knop Geheugen wissen is er gewoon niet.
Sla geen gevoelige geheimen, wachtwoorden, privétokens of vertrouwelijke informatie op in het AI-geheugen.
🧵 Threads
Het lezen en schrijven van geheugen volgt de instellingen Kanalen waar het geheugen mag worden GELEZEN en Kanalen waar het geheugen mag worden GESCHREVEN, en een thread is niet een van die kanalen, ook niet als het kanaal waarin hij is geopend dat wel is. Standaard wordt geheugen in threads niet gelezen en niet geschreven. Met de optie Threads meenemen van AI Response (standaard uit) volgt een thread het kanaal waarin hij is gestart; zie AI-reacties. Laat hem uit als een thread kan openstaan voor mensen die niet mogen zien wat het geheugen bevat.
✨ Geheugen en antwoordkwaliteit
Meer geheugen is niet altijd beter.
Te veel irrelevante feiten kunnen de AI minder gefocust maken.
Goed geheugen is:
- Kort
- Nauwkeurig
- Relevant
- Actueel
- Makkelijk te begrijpen
💡 Tips
- Bekijk het geheugen na grote veranderingen op de server.
- Verwijder verouderde feiten.
- Wis de items van een lid als die vraagt om vergeten te worden, in plaats van zijn rijen op te sporen.
- Hou belangrijke regels duidelijk en expliciet.
- Sla geen privégegevens van gebruikers op, tenzij je daar een goede reden en toestemming voor hebt.
- Gebruik geheugen om de context te verbeteren, niet om moderatie of het oordeel van het team te vervangen.