AudioToText는 음성을 텍스트로 변환해 주는 기능이에요.
음성 채널 전체 녹음과는 별개이며, 서버에서 오디오 메시지나 파일을 읽을 수 있는 텍스트로 바꾸고 싶을 때 쓸 수 있어요.
🎙️ AudioToText가 하는 일
AudioToText는 지원되는 오디오 입력을 받아 텍스트로 변환해요.
이런 경우에 도움이 돼요.
- 접근성
- 모더레이션 검토
- 회의록
- 음성 메시지 요약
- 검색 가능한 기록
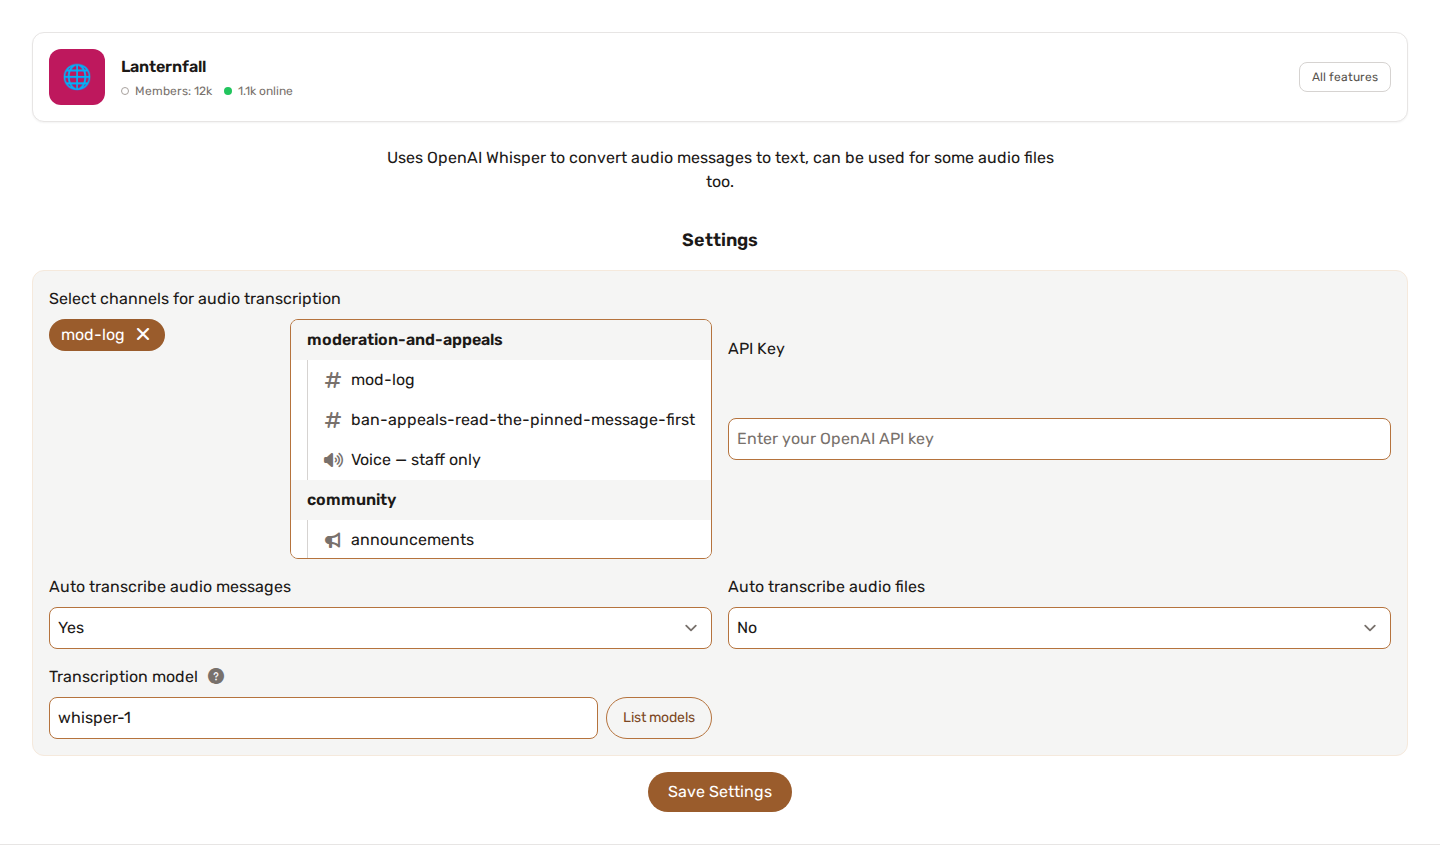
⚙️ 설정
서버 환경에 따라 AudioToText에 다음이 필요할 수 있어요.
- 오디오를 처리할 채널
- API 키
- 텍스트 변환 모델
- 선택 사항인 사용자 지정 텍스트 변환 엔드포인트
- 역할 또는 채널 제한
🔌 사용자 지정 텍스트 변환 엔드포인트
AudioToText는 Whisper 호환 사용자 지정 텍스트 변환 엔드포인트를 사용할 수 있어요.
직접 쓰는 제공자나 자체 호스팅한 텍스트 변환 서비스를 쓰고 싶을 때 유용해요.
자세한 내용은 Custom AI Model Endpoints를 참고하세요.
🧠 텍스트 변환 모델 고르기
텍스트 변환 모델 필드에는 여러분의 엔드포인트가 실제로 제공하는 모델이 표시돼요. 기억에 의존해 적어 둔 목록이 아니라 패널이 엔드포인트에 직접 물어보고, 그중 텍스트 변환이 가능한 모델만 남겨요.
비워 두면 OpenAI가 제공하는 whisper-1을 사용해요. AudioToText를 직접 운영하는 서버에 연결했다면 이 필드가 중요해요. faster-whisper나 distil-whisper 인스턴스는 whisper-1이라는 이름에 응답하지 않는 경우가 많고, 갖고 있지 않은 모델을 요청하는 것이 자체 호스팅 엔드포인트가 아무것도 돌려주지 않는 흔한 이유예요.
↔️ 오디오 녹음과의 차이
AudioToText는 텍스트 변환에 집중해요.
오디오 녹음은 음성 채널 대화를 녹음하는 데 집중하며, 필요하면 텍스트 변환과 요약을 더할 수 있어요.
주로 오디오를 텍스트로 바꾸고 싶다면 AudioToText를, 음성 채널 세션 전체를 담고 싶다면 오디오 녹음을 사용하세요.
💡 모범 사례
- 짧은 오디오로 먼저 테스트하세요.
- 파일 형식이 지원되는지 확인하세요.
- 음질이 좋을수록 결과도 좋아요.
- 서버에 명확한 정책이 없다면 민감한 비공개 오디오에는 텍스트 변환을 쓰지 마세요.
- 모더레이션이나 공식 기록에 활용하기 전에 변환 결과를 검토하세요.