AudioToText 通过转录把音频转换成文字。
它与完整的语音频道录制是分开的,当你的服务器需要把语音消息或音频文件转成可读的文字时就可以使用。
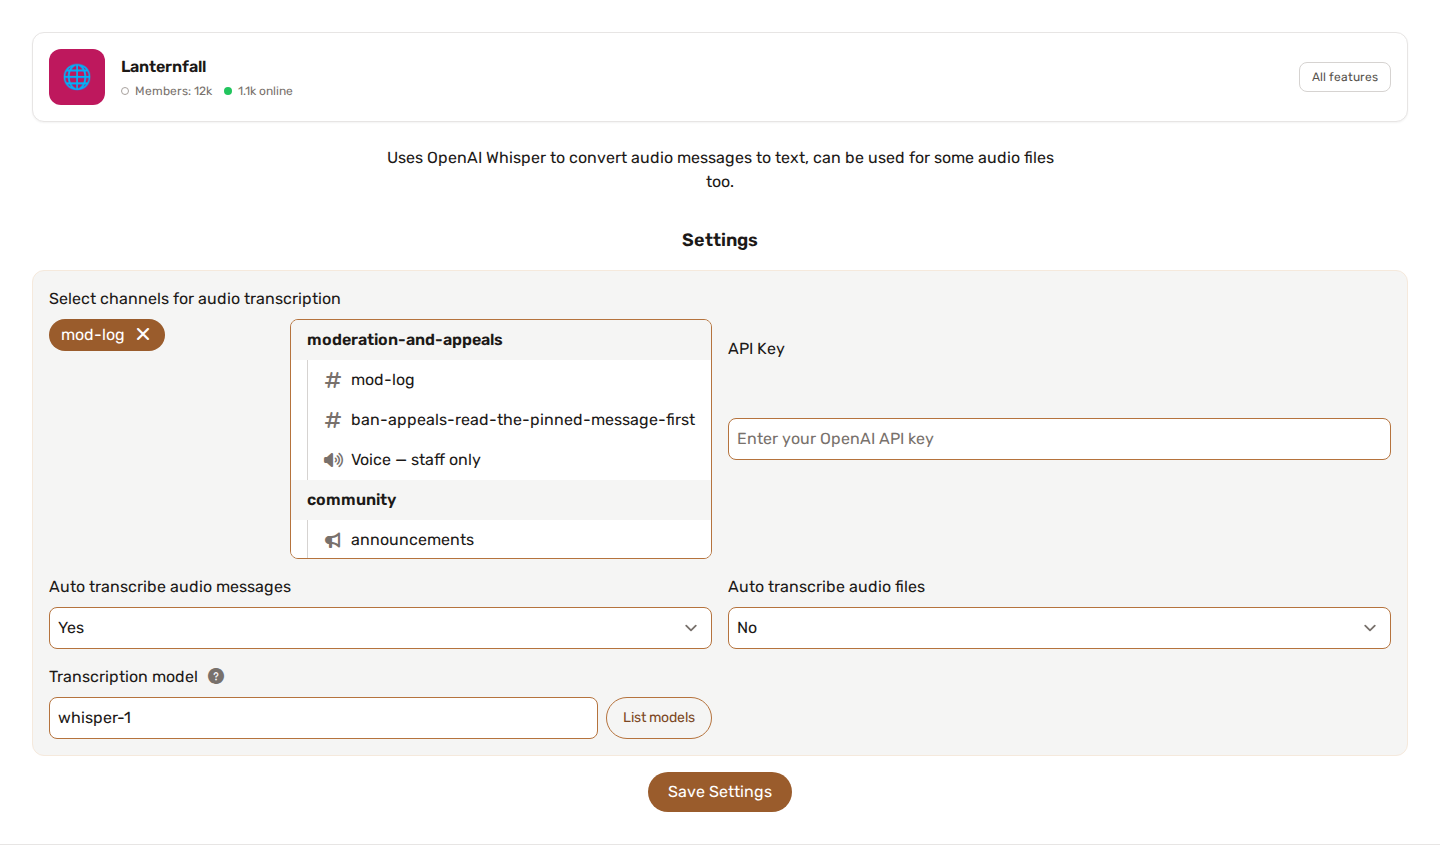
🎙️ AudioToText 能做什么
AudioToText 接收支持的音频输入并生成转录文本。
这可以帮助实现:
- 无障碍
- 审核复查
- 会议记录
- 语音消息摘要
- 可搜索的记录
⚙️ 配置
根据你的服务器设置,AudioToText 可能需要:
- 一个用来处理音频的频道
- 一个 API 密钥
- 一个转录模型
- 可选的自定义转录端点
- 身份组或频道限制
🔌 自定义转录端点
AudioToText 可以使用兼容 Whisper 的自定义转录端点。
如果你想使用自己的服务商或自行托管的转录服务,这会很有用。
更多详情请参阅 自定义 AI 模型端点。
🧠 选择转录模型
转录模型 字段会列出你的端点实际发布的模型(面板会向它查询,而不是显示一份凭记忆写成的列表),并且只保留能够转录的那些。
留空时会使用 whisper-1,也就是 OpenAI 提供的那个。如果你把 AudioToText 指向你自己的服务器,这个字段就很关键:faster-whisper 或 distil-whisper 实例很少会响应 whisper-1 这个名称,而向它请求一个它没有的模型,正是自行托管的端点没有返回结果的常见原因。
↔️ 与音频录制的区别
AudioToText 专注于转录。
音频录制专注于录下语音频道里的对话,并且可以选择性地加上转录和摘要。
如果你主要是需要把音频转成文字,就用 AudioToText。如果你需要录下完整的语音频道会话,就用音频录制。
💡 最佳实践
- 先用一小段音频测试。
- 确认文件格式受支持。
- 使用清晰的音频可以获得更好的效果。
- 除非你的服务器有明确的政策,否则避免对敏感的私人音频使用转录。
- 在把转录文本用于审核或正式记录之前,先复查一遍。